

Heute stellen wir Altar vor – unser erstes Open-Weight-Sicherheitsmodell, das entwickelt wurde, um defensive Sicherheit auf Spitzenniveau in eine Infrastruktur zu bringen, die Sie kontrollieren.
Mit unserem Gerät für autonomes Penetrationstesting, Aikido Machine, haben wir den ersten Schritt in Richtung souveräner Security Intelligence gemacht. Es läuft vollständig in der eigenen Infrastruktur eines Kunden, einschließlich vollständig isolierter (Air-Gapped-)Umgebungen. Teams mit strengen Richtlinien zur lokalen Aufbewahrung von Code können Schwachstellen in ihrer gesamten Angriffsfläche kontinuierlich erkennen, ausnutzen und validieren, ohne diese Regeln zu verletzen.
Altar versorgt Aikido Machine mit fortschrittlicher KI, die verteidigt, ohne den sensibelsten Kontext einer Organisation an einen Inferenzdienst eines Drittanbieters zu senden.
Um dies zu erreichen, mussten wir die Bereitstellungslücke (Deployment Gap) schließen. Die meisten leistungsfähigen Open-Weight-Modelle lassen sich nur schwer in der Produktion skalieren und behalten dabei gleichzeitig die Schlussfolgerungsqualität von Modellen der Spitzenklasse bei.
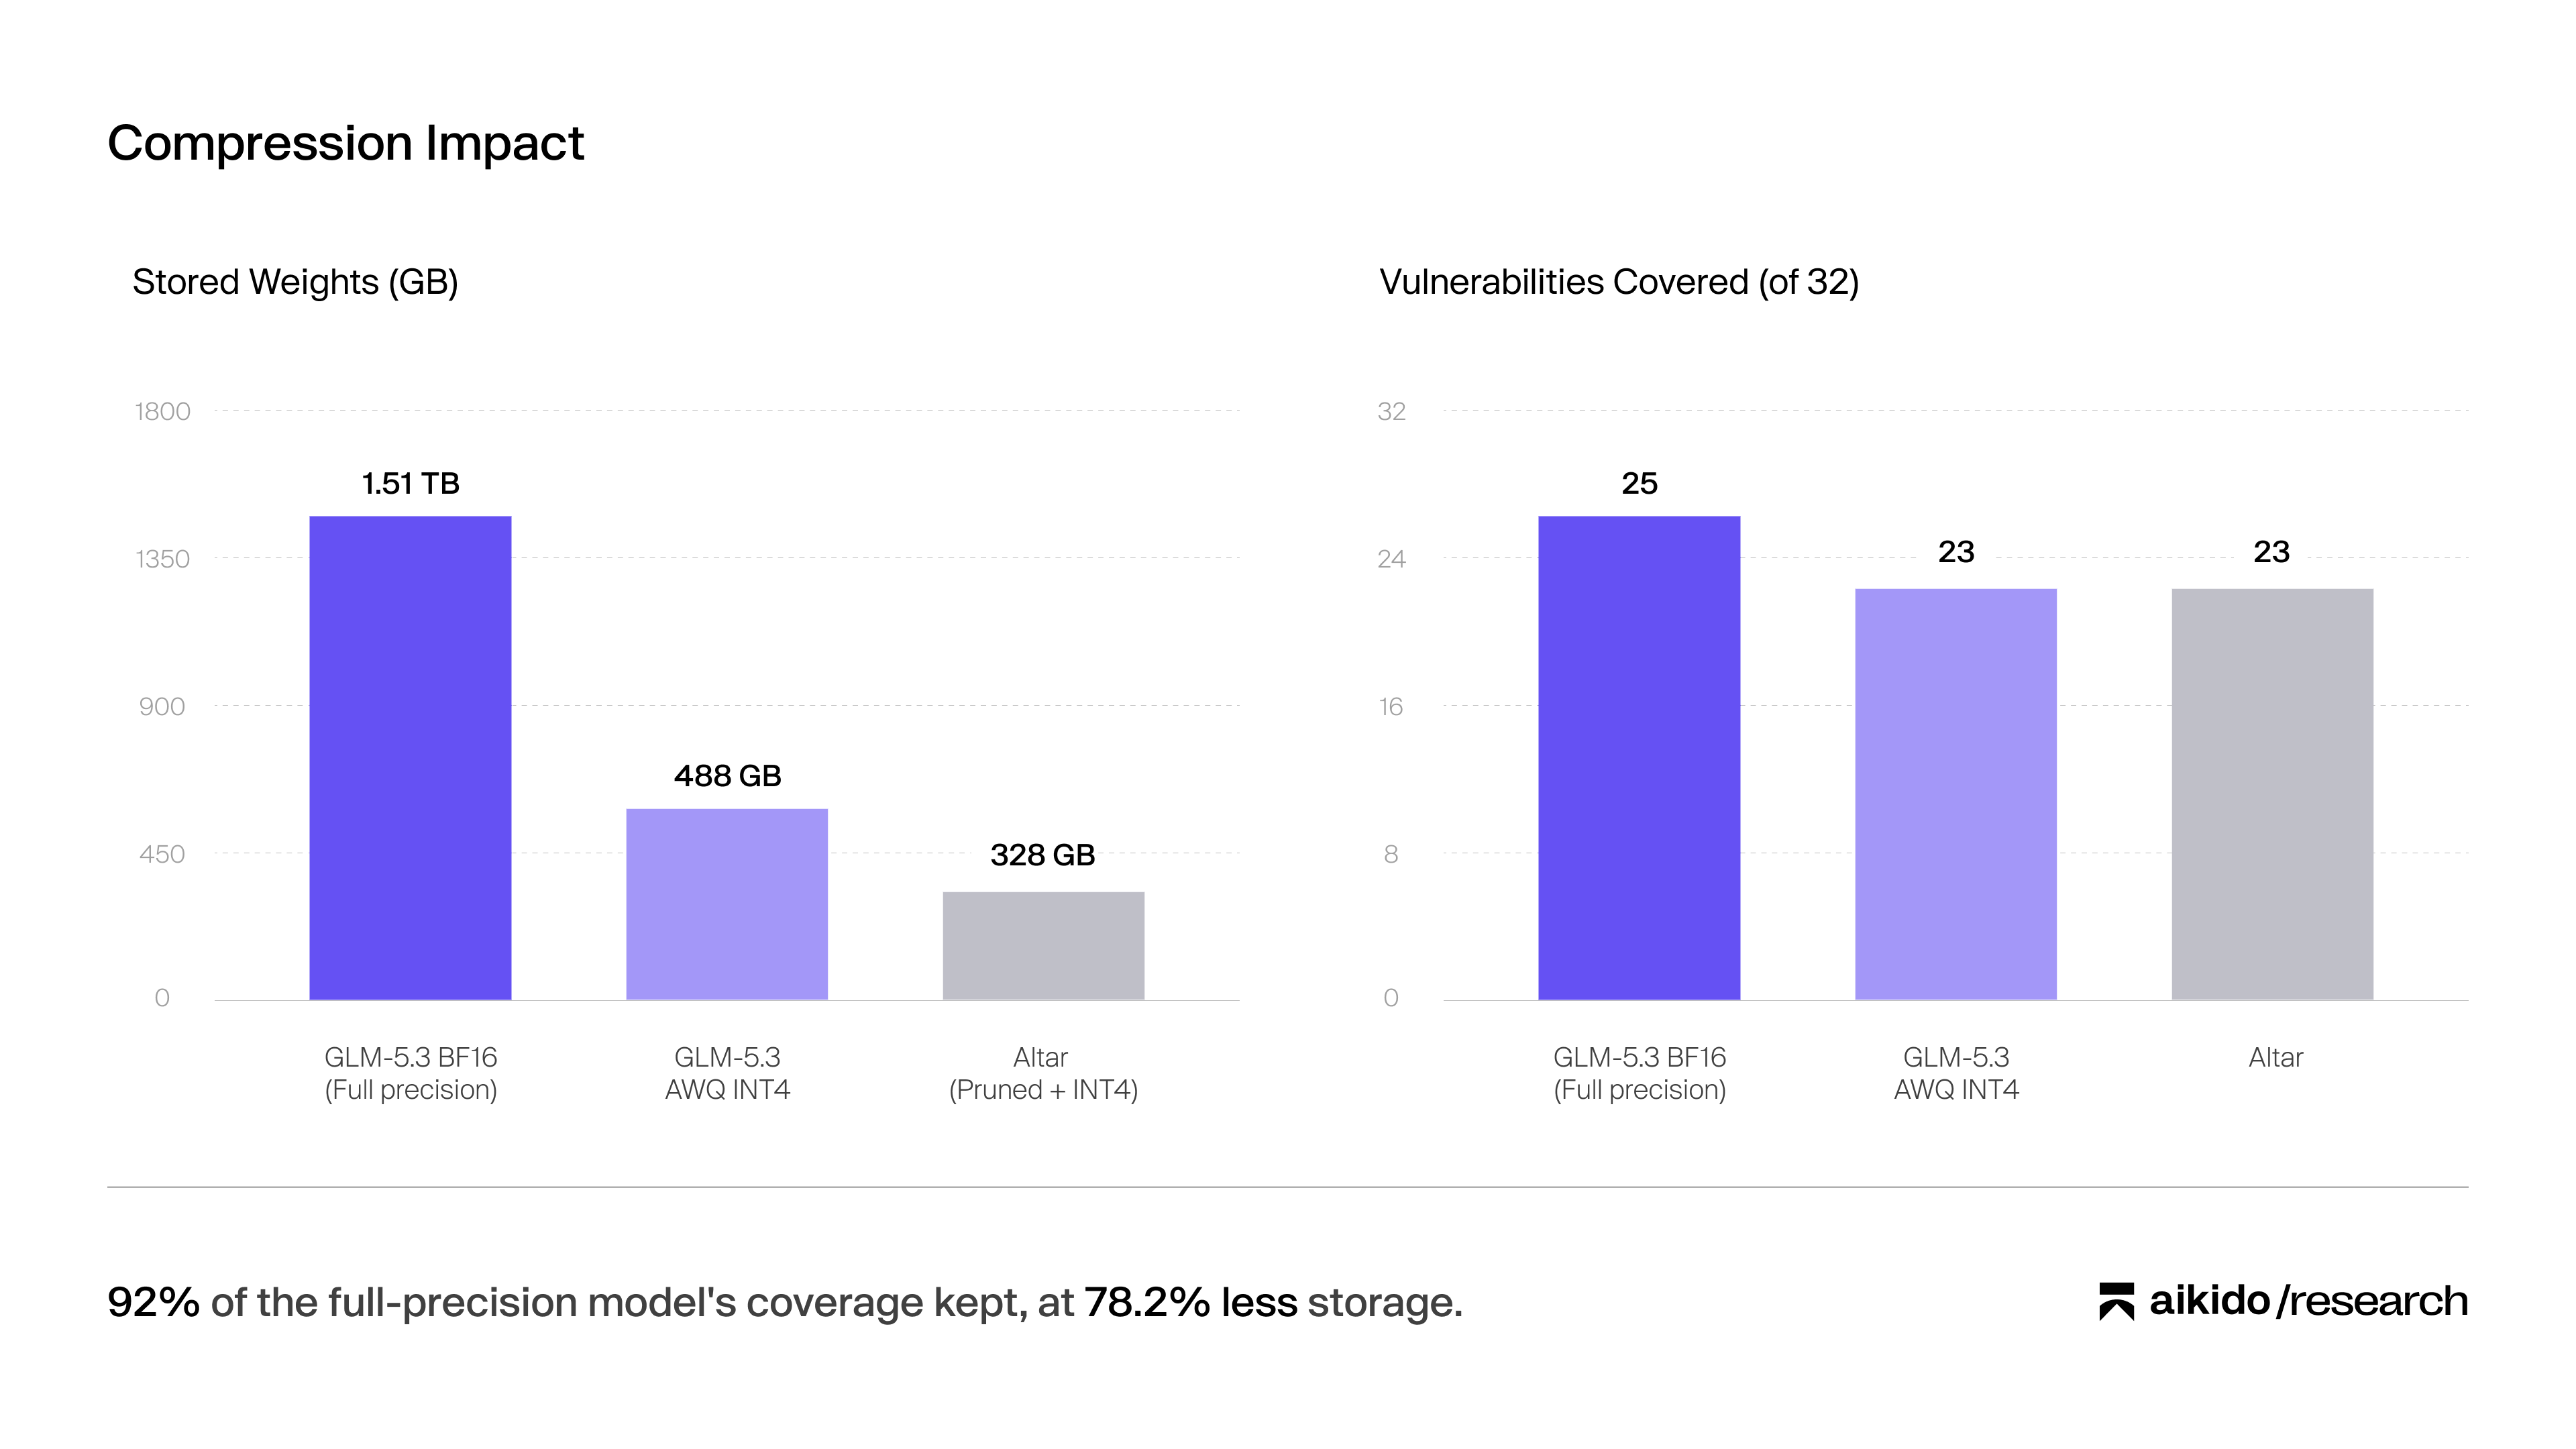
Wir begannen mit GLM-5.3, einem der stärksten Modelle in unseren Sicherheitsauswertungen. Das vollständige Modell umfasst 1,51 TB; durch Quantisierung wird dies auf 488 GB reduziert, und unser Expert-Pruning-Prozess verringert es weiter auf 328 GB – und das bei weitgehendem Erhalt der Schlussfolgerungsqualität des Ausgangsmodells.
Die Lücke zwischen Modellen der Spitzenklasse und Open-Weight-Modellen erklärt
Geschlossene Spitzenmodelle laufen auf der Infrastruktur anderer Anbieter
Die Nutzung eines solchen Modells bedeutet, dass Ihr Quellcode, Ihre Dokumentation zur internen Architektur und Ihre noch nicht behobenen Befunde Ihr Netzwerk verlassen. Für eine Bank, die strengen Vorgaben zur Datenresidenz unterliegt, eine Klinikgruppe mit strengen Regeln zur Datenverarbeitung oder ein Industrieunternehmen, dessen OT-Umgebung keinerlei Verbindung zum Internet hat, ist dies ein Kompromiss, den sie nicht eingehen dürfen.
Die Bereitstellungslücke
Die Bereitstellung eines Modells wie GLM 5.3 in voller Präzision erfordert Hunderte von Gigabytes an Unified Memory und führt bei der Verarbeitung paralleler Konversationen mit großen Kontextfenstern zu einer begrenzten Inferenzgeschwindigkeit. Menschlich ausgedrückt: Sie sind enorm groß.
Diese Ressourcenanforderungen rühren teilweise daher, wie diese Modelle aufgebaut sind. Viele der heutigen stärksten Modelle verwenden Mixture-of-Experts-Architekturen. Diese Modelle bestehen aus einer Vielzahl kleiner, spezialisierter neuronaler Netze, die jeweils als Experte bezeichnet werden. Nur eine kleine Anzahl von Experten ist für jeden Token aktiv, während der gesamte Expertenpool dennoch gespeichert und bereitgestellt werden muss. Das bedeutet erhebliche Speicher- und Infrastrukturkosten für eine Kapazität, die möglicherweise kaum zu der von Ihnen tatsächlich ausgeführten Arbeitslast beiträgt.
Sicherheitsarbeiten wie das Überprüfen von Code auf Schwachstellen, das Vorschlagen von Patches und das Durchführen von Penetrationstests beanspruchen nur einen kleinen Teil dieses Expertenpools. Die Speicherkosten schrumpfen jedoch nicht entsprechend: Jede Anfrage muss weiterhin das gesamte Modell laden, unabhängig davon, ob es für die Aufgabe relevant ist oder nicht.
Fügt man nun noch Agenten hinzu, explodiert der Kontextverbrauch, was den Speicher überlastet und dazu führt, dass sich die Agenten gegenseitig um Speicherplatz konkurrieren. Jeder Agent führt ein laufendes Protokoll über alles, was er gesehen und getan hat, und dieses Protokoll befindet sich zusammen mit dem Modell selbst im GPU-Speicher. Es wächst, je länger eine Untersuchung läuft, und vervielfacht sich mit jeder parallel laufenden Untersuchung.
Aus diesem Grund ist die Modellgröße hier von Bedeutung: Das Modell und der gesamte wachsende Kontext greifen auf denselben festen Speicherpool zu, sodass mehr von dem einen weniger Platz für das andere lässt. Das Ziel besteht darin, den Betrieb eines Spitzenmodells für eine spezifische Arbeitslast effizienter zu gestalten, die wichtigen Funktionen zu erhalten und gleichzeitig Kapazität für alles frei zu machen, was parallel dazu läuft.
Was können wir entfernen, ohne das Wesentliche zu verlieren?
Die schwere Last, so viele Experten in einem Modell mitzuführen, lässt sich mit den richtigen Techniken in einen Vorteil verkehren. Um die Größe von Open-Weight-Modellen in einem Agenten-basierten Sicherheitskontext zu minimieren und gleichzeitig eine hohe Genauigkeit beizubehalten, haben wir Quantisierung und Pruning eingesetzt.
Expert Pruning entfernt einige der Experten aus dem Modell, typischerweise durch das Löschen kompletter Expertengewichtsblöcke und die Anpassung des Modells, sodass jeder Token nur noch unter den verbleibenden auswählt. Das Entfernen selbst ist mechanisch. Die schwierige Aufgabe besteht darin, zu entscheiden, welche Experten entfernt werden sollen, und der Verlust kann ungleichmäßig ausfallen: Ein kleineres Modell behält möglicherweise seine starke Codierungsleistung bei, verliert jedoch einen Großteil seiner Fähigkeit, eine bestimmte natürliche Sprache zu verstehen. Dies kann dazu führen, dass es Dokumentationen, Geschäftsregeln oder in dieser Sprache beschriebene Anwendungsfunktionen nicht mehr zuverlässig interpretieren kann.
Um zu entscheiden, was erhalten bleibt, begannen wir mit den natürlichsten Daten: Traces von unserem Penetrationstesting-Harness, das interne Benchmarks ausführt. Diese erfassen den Code, die Tool-Aufrufe und die Antworten, die Agents während eines vollständigen Pentests durcharbeiten, und liefern uns so repräsentative Eingaben zur Steuerung der Expertenauswahl. Es waren zu keinem Zeitpunkt Kundendaten beteiligt.
Dieser Kalibrierungsschritt bietet uns eine arbeitslastspezifische Grundlage für die Expertenauswahl, ohne dem Modell neue Fähigkeiten antrainieren zu müssen.
Die Harness-Traces deckten die technische Arbeitslast ab. Wir mussten auch das Sprachverständnis bewahren: Die Untersuchung einer Anwendung bedeutet, ihre Funktionen, Geschäftsregeln und beabsichtigten Workflows zu verstehen – auch dann, wenn sich ihre Dokumentation oder Benutzeroberfläche auf Französisch, Niederländisch oder in einer anderen Sprache befindet. Daher haben wir mehrsprachigen Text hinzugefügt, um diese Fähigkeiten während des Prunings zu bewahren.
Die Auswahl ist ebenso wichtig wie die Größe
Es gibt viele Pruning-Techniken zur Verringerung des Footprints von LLMs. Daher haben wir uns für eine Technik entschieden, die die Leistung für unsere Anwendungsfälle bewahren kann: Cerebras REAP, Router-weighted Expert Activation Pruning. Wir haben den Beitragsscore von REAP zusammen mit einer domänenerhaltenden Aggregationsstrategie verwendet, die durch Genauigkeitsexperimente ausgewählt wurde. Die reine Zählung, wie oft ein Experten ausgewählt wird, liefert nur ein unvollständiges Bild. REAP schätzt seinen Beitrag sowohl anhand der Gewichtung des Routers als auch anhand des Betrags der Ausgabe des Experten ein.
Wir untersuchen auch Beiträge über verschiedene Gruppen von Beispielen hinweg. Andernfalls kann eine Fähigkeit, die für eine weniger verbreitete Arbeitslast wichtig ist, in einem Gesamtdurchschnitt verloren gehen. Cybersicherheits-, Programmier- und Sprachfähigkeiten sind über Experten verteilt; es gibt keinen klar definierten Satz von „Cyber-Experten“, den man behalten oder verwerfen könnte.
In der unterstützenden Komprimierungsstudie wichen Modelle, die dieselbe Anzahl an Experten behielten, erheblich darin ab, wie genau ihre Ausgaben dem Referenzmodell entsprachen. Die Größe allein war nicht ausschlaggebend dafür, was überlebte.
Von 1,51 TB auf 328 GB
Wir haben eine Gesamtreduzierung der Modellgröße um 78,2 % im Vergleich zu GLM 5.3 bei voller Präzision und eine Reduzierung um 32,8 % im Vergleich zu GLM 5.3 mit einer AWQ-INT4-Quantisierung erreicht. Altar behält in jeder Backbone-Experten-Schicht 168 der ursprünglich 256 gerouteten Experten bei, wodurch 88 oder 34,4 % entfernt werden. Der Router wählt nach wie vor acht pro Token aus, nun jedoch aus dem kleineren Pool.
Der andere Teil der Reduzierung stammt von der Quantisierung. Die Gewichte eines Modells sind die numerischen Werte, die es während des Trainings lernt. Bei der Quantisierung werden diese Zahlen mit weniger Bits gespeichert, wobei etwas Präzision gegen kleinere gespeicherte Gewichte eingetauscht wird. Im Gegensatz zum Pruning werden dabei keine Experten entfernt.
Unser Ausgangs-Checkpoint nutzte AWQ, um die meisten Expertengewichte in vier Bits statt in den sechzehn des BF16-Modells zu speichern. AWQ verwendet Informationen über die Aktivität des Modells bei Beispieleingaben, um die durch geringere Präzision verursachten Fehler zu begrenzen. Die während der Inferenz erzeugten Zwischenwerte, die als Aktivierungen bezeichnet werden, bleiben 16-bit: daher W4A16 bzw. Vier-Bit-Gewichte und 16-Bit-Aktivierungen. Einige Gewichte behalten zudem eine höhere Präzision bei. Wir haben dann Pruning auf diesen bereits quantisierten Checkpoint angewendet.
Ein Vergleich beider übergeordneter Repräsentationen zeigt, was die einzelnen Schritte bewirken:
Das sind 78,2 % weniger Speicherbedarf als beim vollständigen 16-Bit-Modell. Gegenüber dem bereits quantisierten Vorgänger entfernt das Pruning weitere 160 GB, was einer Reduzierung um 32,8 % entspricht.
Die Auswirkungen der Komprimierung auf die Fähigkeit zur Schwachstellenerkennung
Wir haben zuvor einen internen CVE-Benchmark entwickelt, mit dem wir die Fähigkeit eines Modells bewerten, komplexe reale Schwachstellen mithilfe unseres KI-Codeanalyse-Harness zu identifizieren: 32 bekannte Schwachstellen in 30 Repositories, mit drei Durchläufen pro Fall.
Wir haben Altar an diesem Benchmark getestet. Altar erzielte im Durchschnitt einen Recall von 60,4 % pro Durchlauf und entdeckte 23 der 32 Schwachstellen in drei Durchläufen mindestens einmal wieder.
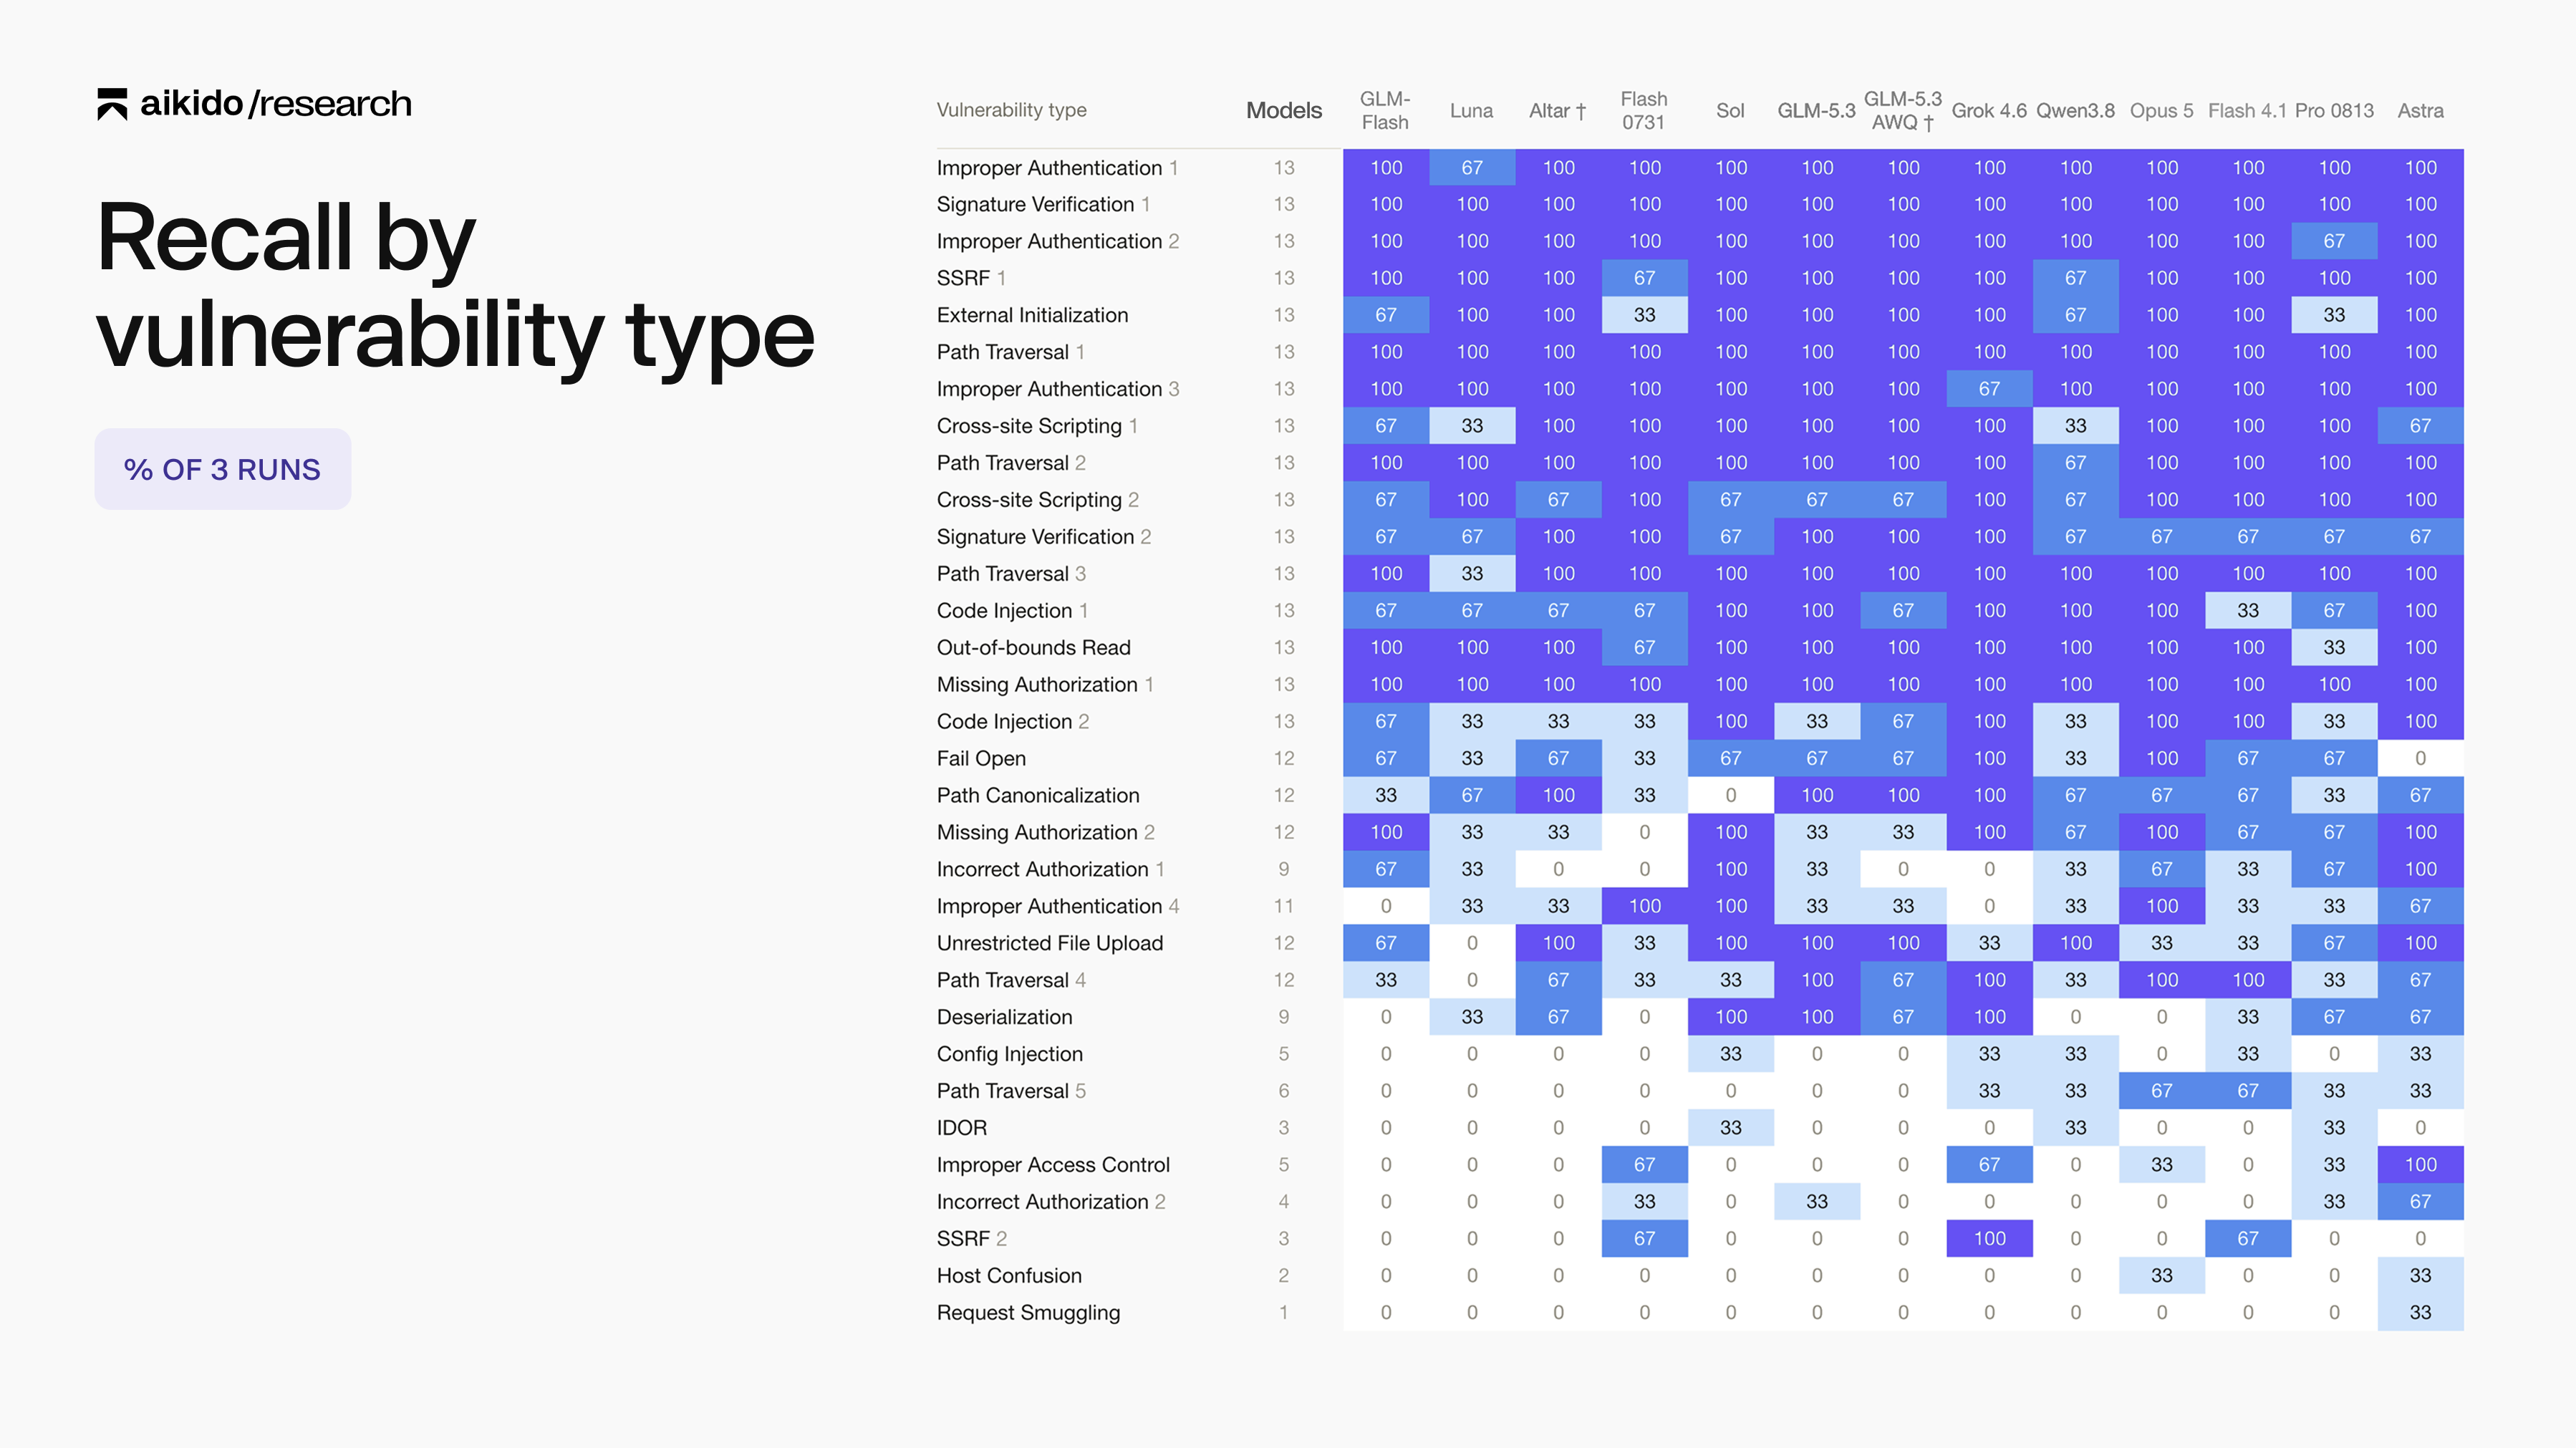
Zum Vergleich: Das quantisierte GLM-5.3 AWQ erreichte durchschnittlich 61,5 % Recall und deckte dieselben 23 Schwachstellen ab. Das ursprüngliche GLM-5.3-Modell bei voller Präzision erzielte durchschnittlich 65,6 % Recall und deckte 25 von 32 ab.
Mit anderen Worten: Die Reduzierung des bereits quantisierten Checkpoints von 488 GB auf 328 GB – eine Verringerung der gespeicherten Gewichte um 32,8 % – führte im Vergleich zur AWQ-Baseline zu einem um etwa einen Prozentpunkt geringeren durchschnittlichen Recall, während die vollständige Schwachstellenabdeckung erhalten blieb. Verglichen mit dem ursprünglichen Vorgänger behielt Altar 23 seiner 25 abgedeckten Schwachstellen bei (92 %) bei einem Rückgang des durchschnittlichen Recalls um 5,2 Prozentpunkte. Das sind 92 % der Schwachstellenabdeckung des Vorgängers bei 33 % weniger Speicherplatz.
Das ist genau der Kompromiss, den wir angestrebt haben: ein spürbar kleineres Modell unter Beibehaltung des Großteils der Sicherheitsfunktionen des Vorgängers.
Wir berichten den durchschnittlichen Recall pro Durchlauf getrennt von der Abdeckung über drei Durchläufe hinweg: Eine Schwachstelle einmal zu finden ist etwas anderes, als sie konsistent zu finden. Abgeschlossene Durchläufe ohne Fund werden als Fehlschläge gezählt; unvollständige Durchläufe werden separat ausgewiesen.
Dies misst die gezielte CVE-Wiederentdeckung innerhalb einer Pipeline, die für umgebende Phasen andere Modelle verwendet. Es misst weder die blinde Entdeckung in einer gesamten Codebasis, noch führt es Exploits zur Validierung von Funden aus oder bewertet die Phase der Fix-Vorschläge. Diese Grenzen halten den Benchmark von dem umfassenderen Pentesting-Workflow getrennt, für dessen Unterstützung wir Altar entwickeln.
Darüber hinaus haben wir Altar unmittelbar nach Abschluss dieser Evaluierungen in unserer Aikido Machine-Flotte eingesetzt. Kurz nach der Bereitstellung identifizierte das System während eines Kunden-Produktions-Pentests eine valide Schwachstelle mit kritischem Schweregrad.
{{cta}}
Ausblick
Der zugrundeliegende Gedanke ist umfassender: Souveräne Sicherheitsintelligenz sollte in jeder Umgebung laufen, die sie schützt.
Altar ist erst der Anfang. Bei der Komprimierung erforschen wir Formate mit niedrigerer Bitzahl wie EXL3, mit denen wir mehr Experten beibehalten könnten, sowie weitere Optimierungen für das H200-Serving.
Der nächste Schritt besteht darin, über die Komprimierung hinaus in Richtung Training zu gehen: Feinabstimmung von Modellen für Sicherheits-Workflows, Verbesserung der Tool-Nutzung und des Langstrecken-Reasoning sowie Aufbau einer selbstlernenden Pipeline, die durch unsere internen Benchmarks informiert wird, um zukünftige Modelle zu leiten und zu formen.
Diese Arbeit wird sich über Schwachstellenforschung, Code-Analyse, Behebung und andere defensive Sicherheits-Workflows erstrecken.
Aikido Labs existiert, um dies weiter voranzutreiben: Modelle, die mit der Zeit leistungsfähiger werden, ohne die entscheidende Einschränkung zu verlieren, dass Verteidiger sie vollständig in den Umgebungen ausführen können müssen, für deren Schutz sie verantwortlich sind.
Vielen Dank an Z.AI für GLM-5.3, Cerebras für REAP, cyanwiki für das quantisierte Modell und 0xSero für die Komprimierungsarbeit. Die öffentliche Fidelity-Studie nebst Plänen und das Pruning-Toolkit bieten mehr technische Details, ohne rohe Agenten-Konversationen zu veröffentlichen.
Die Weights von Altar sind unter der Aikido-Organisation verfügbar. Altar kann bequem mit einem 4-H200-Knoten und der neuesten Version von vLLM bereitgestellt und betrieben werden. Laden Sie Altar herunter für Model Card, Lizenz, Serving-Flags und Bereitstellungsanweisungen.
Benötigen Sie Hilfe beim Betrieb in Ihrer eigenen Umgebung? Kontaktieren Sie das Sales-Team, um die Bereitstellung von Altar On-Premises zu besprechen.
Dieser Ansatz wird auf die gesamte Produktlinie von Aikido ausgeweitet, einschließlich Aikido Attack (AI pentesting), Code Security Audit und Deep PR Review.




