Wir haben 11,7 Milliarden Token verbrannt, um das beste Cyber-KI-Modell zu finden
GLM5.3 und DeepSeek sind jetzt Modelle der Spitzenklasse
Sie möchten die neuesten Benchmarks sehen? Besuchen Sie die Aikido Arena, die wir regelmäßig aktualisieren.
Wir haben 11,7 Milliarden Token aufgewendet, um die Cyber-Fähigkeiten von 10 KI-Modellen mit jeweils drei Versuchen zu benchmarken, anhand von 32 fabrikneuen, standardmäßigen Schwachstellen, die es wiederzuentdecken galt.
Dieses Benchmark ist eine Weiterentwicklung unseres frühzeitigeren Bekannte-CVE-Benchmarks mit einem frischeren, schwierigeren Datensatz, mehr Modellen und einem genauen Blick darauf, was sie finden, wie zuverlässig sie es finden sowie auf ihre Besonderheiten und Kompromisse.
Damit nehmen wir GLM-5.3, DeepSeek V4 Pro 0813, DeepSeek V4 Flash 0731, Qwen3.8-Max, Kimi K3 und Grok 4.6 in unser Line-up auf.
TL;DR:
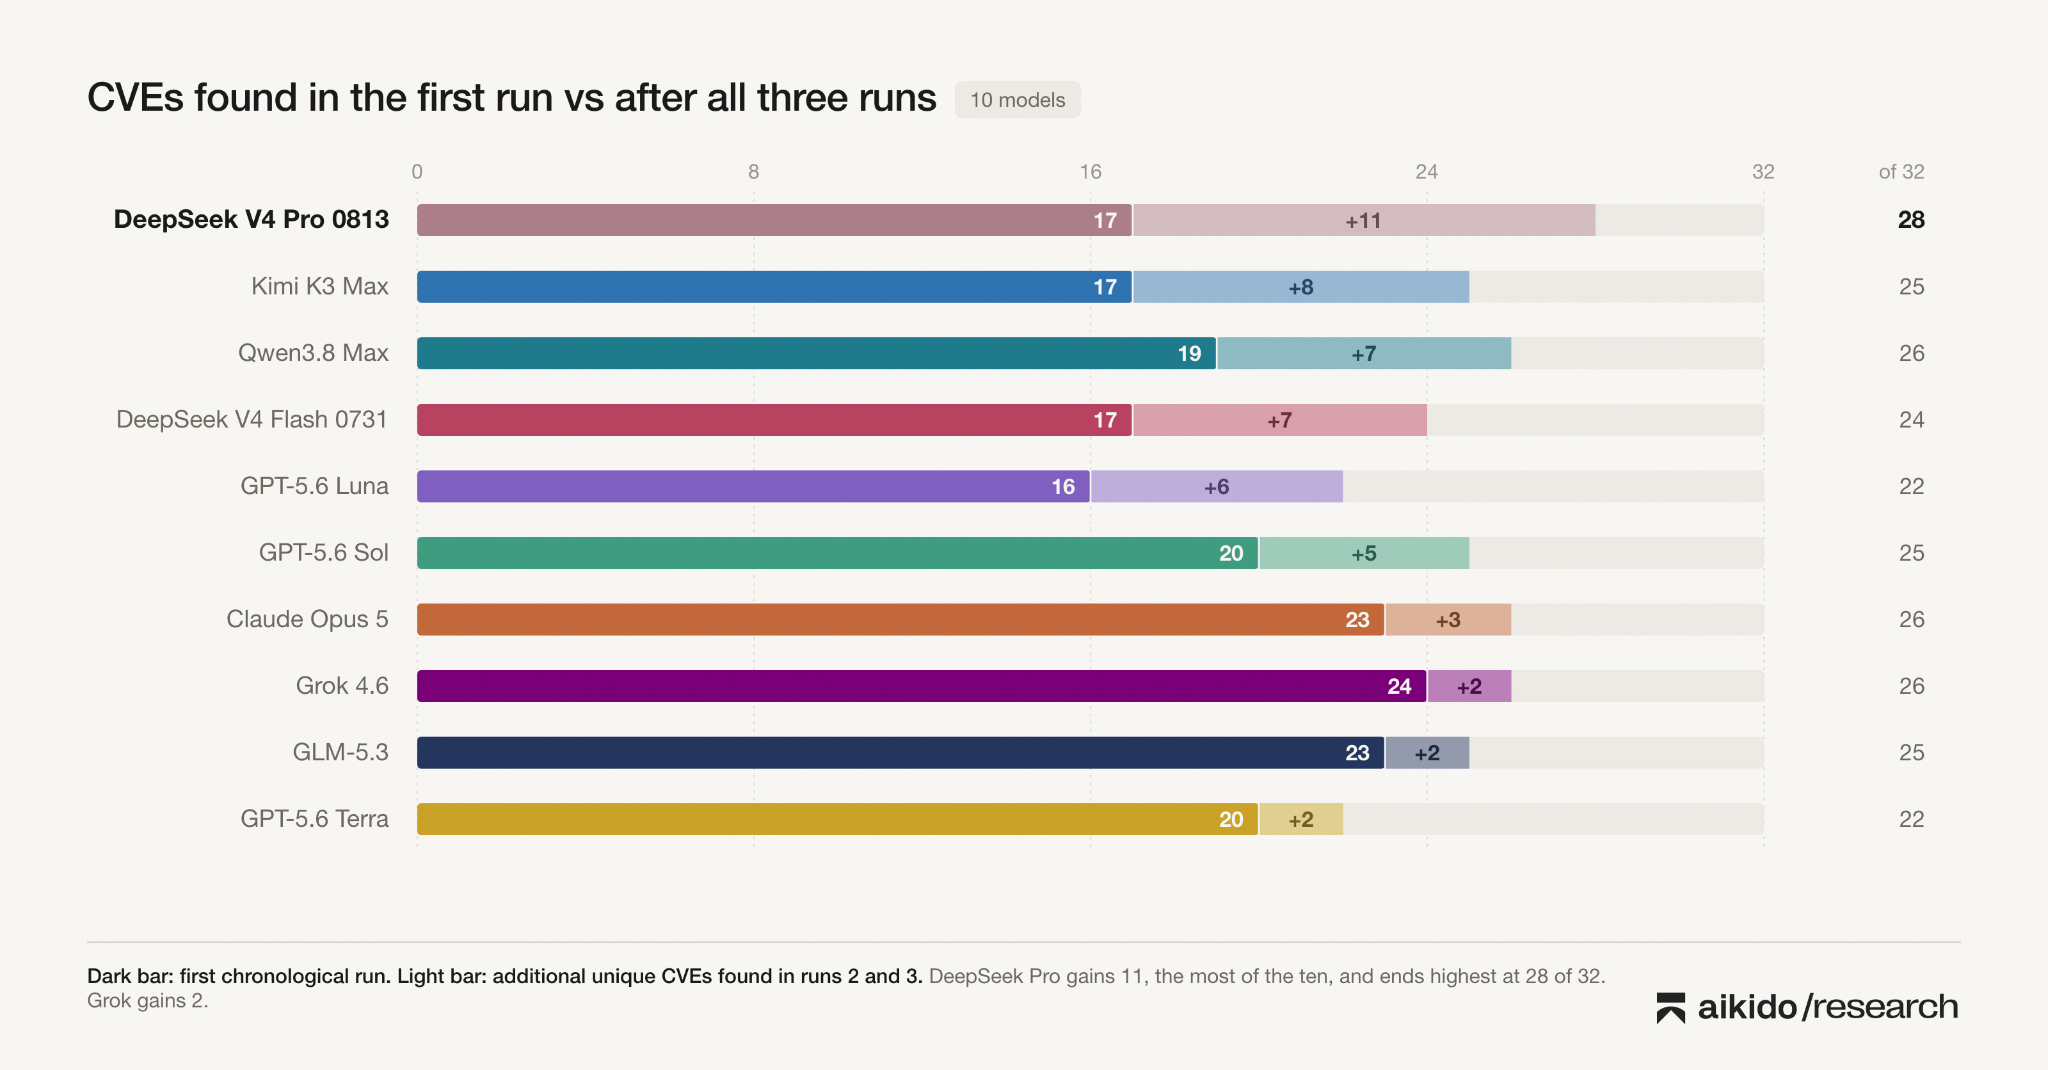
DeepSeek V4 Pro 0813 findet die meisten Schwachstellen. Durch die Zusammenlegung von drei Durchläufen werden 28 von 32 Schwachstellen entdeckt.
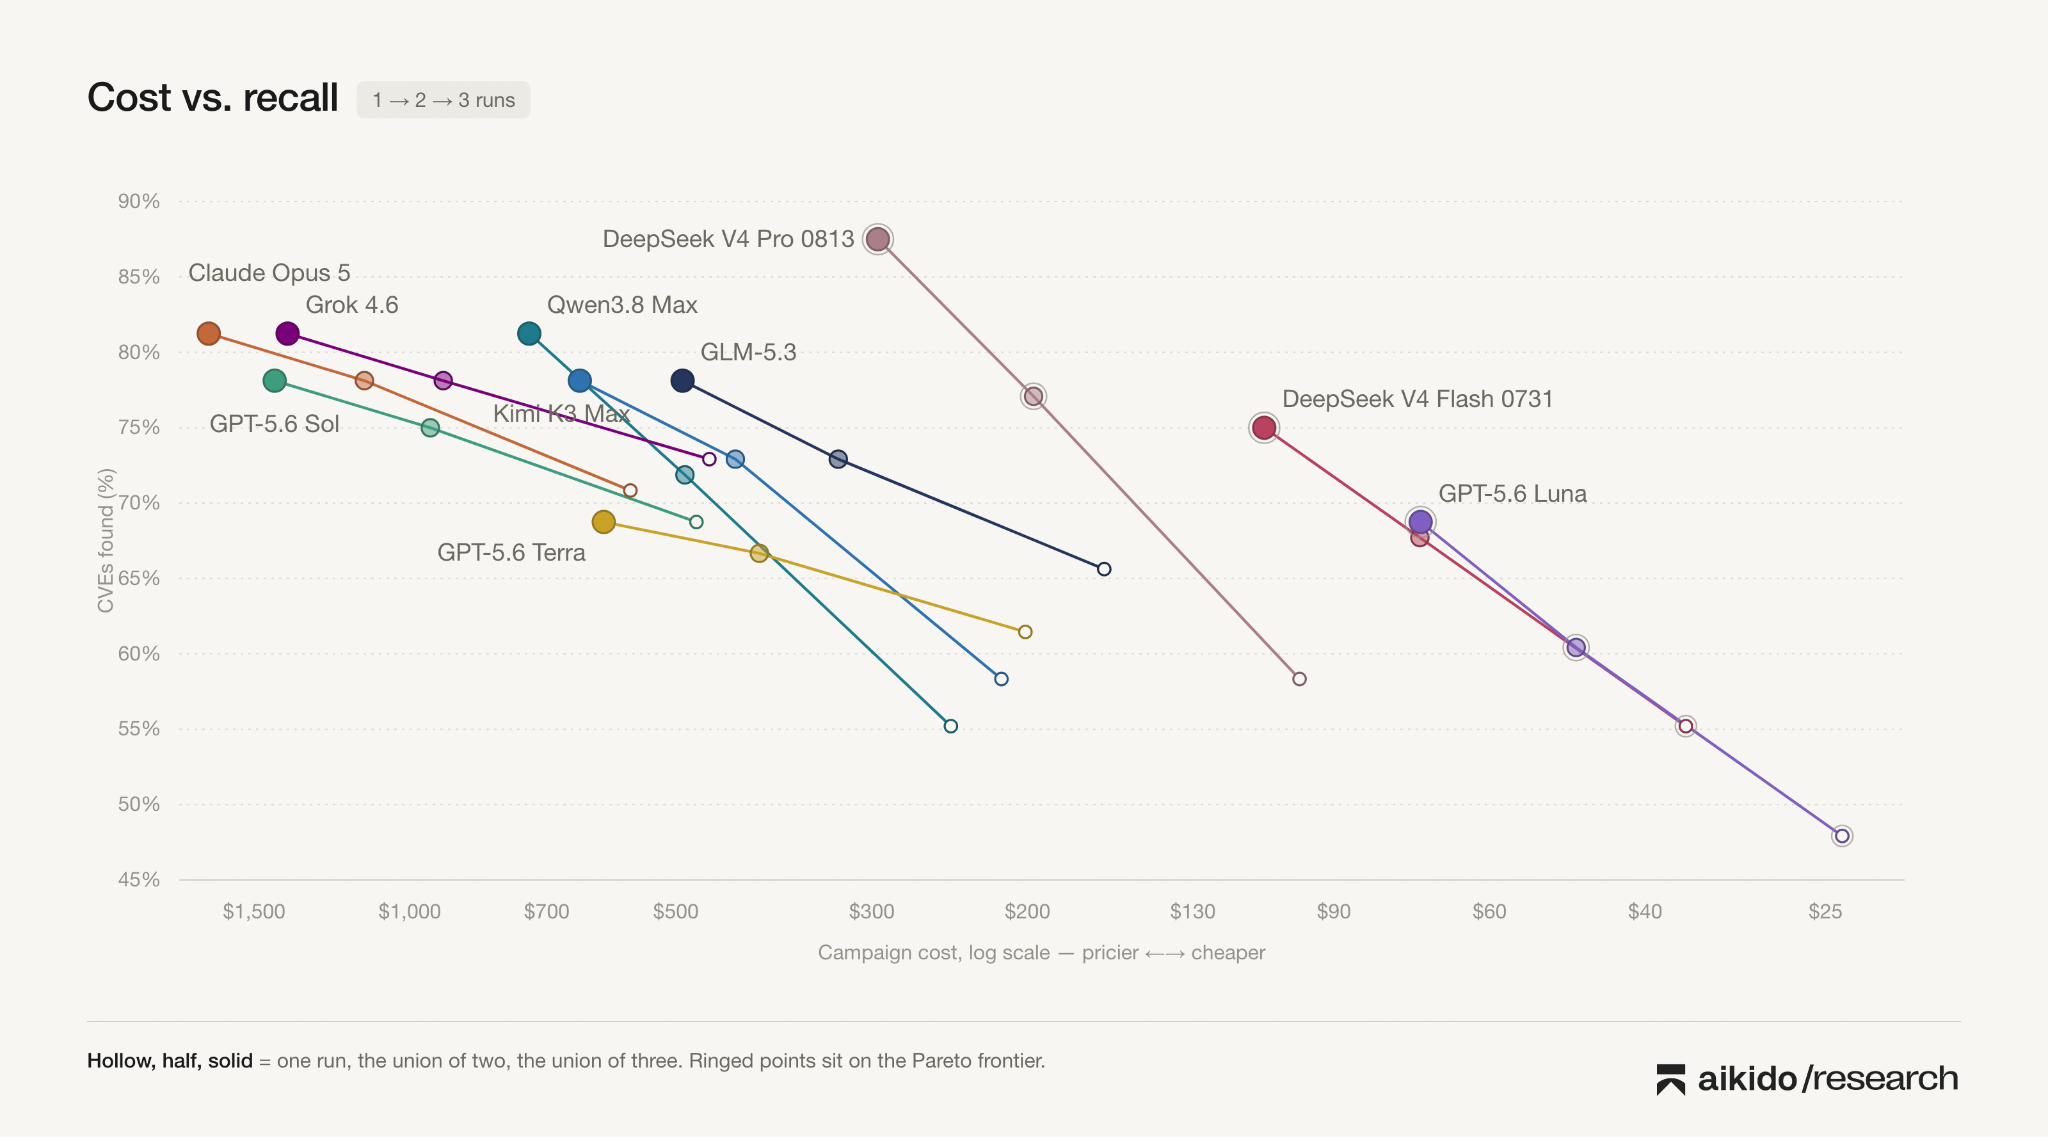
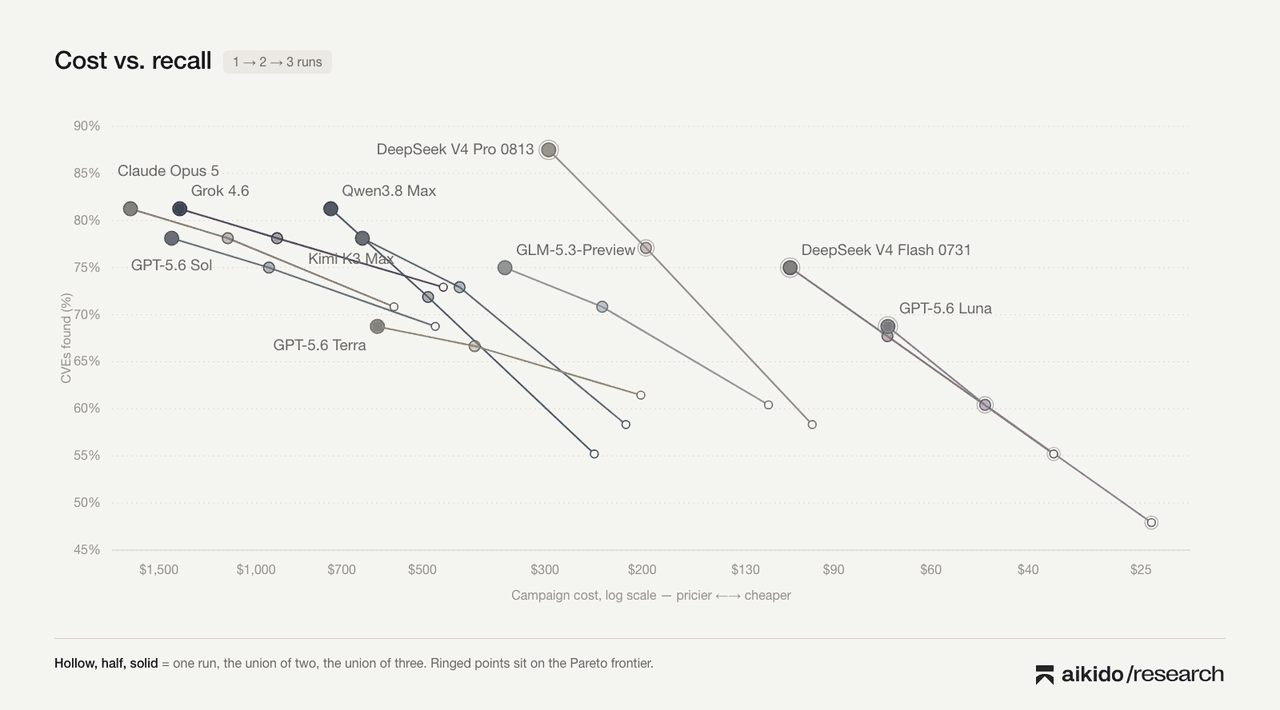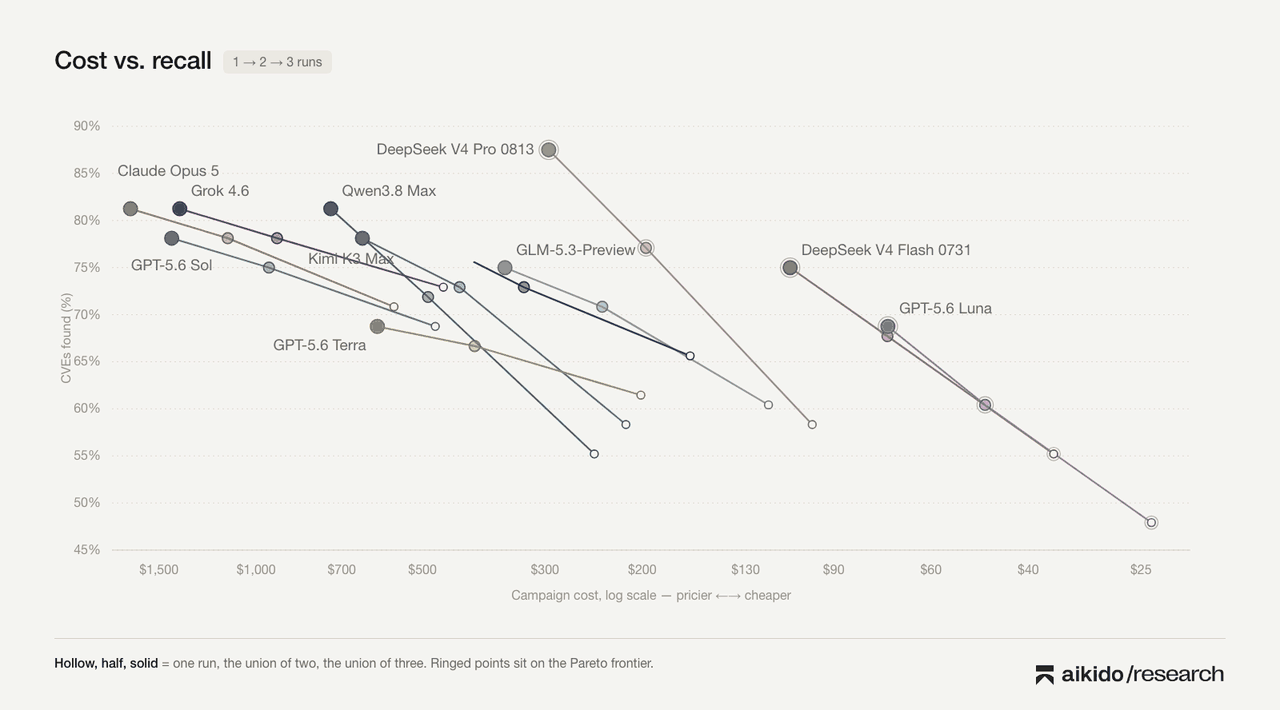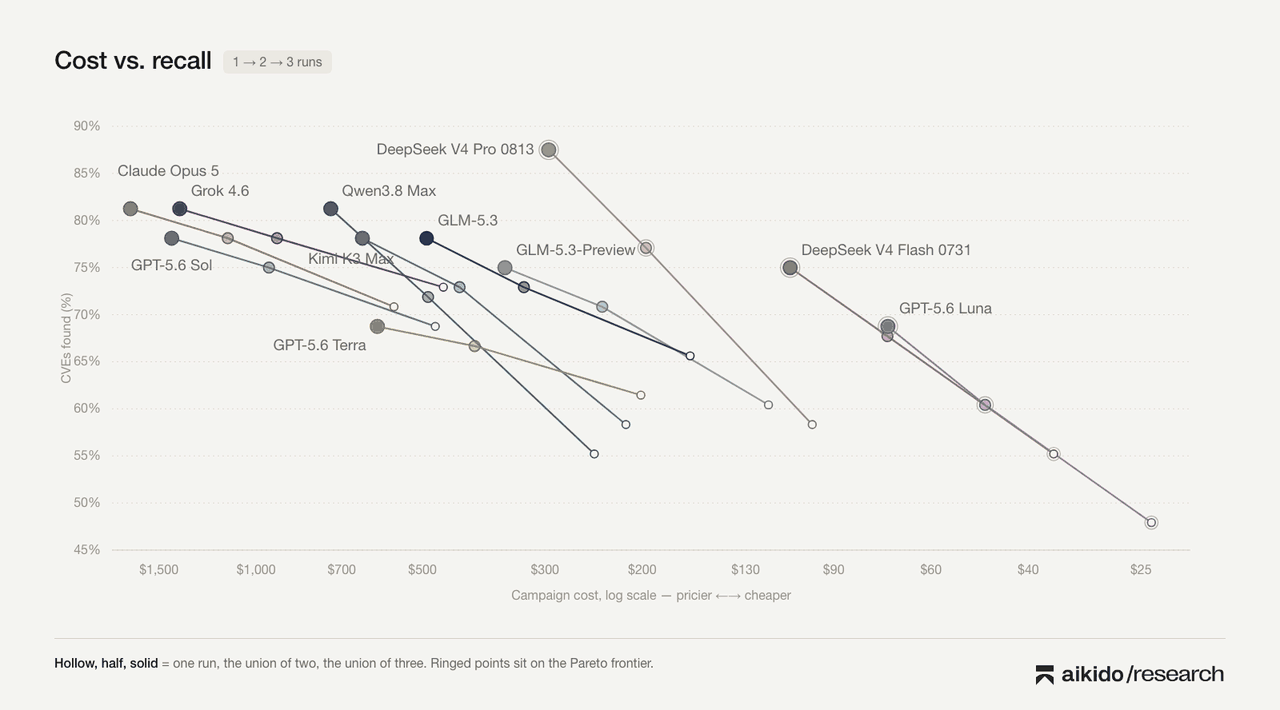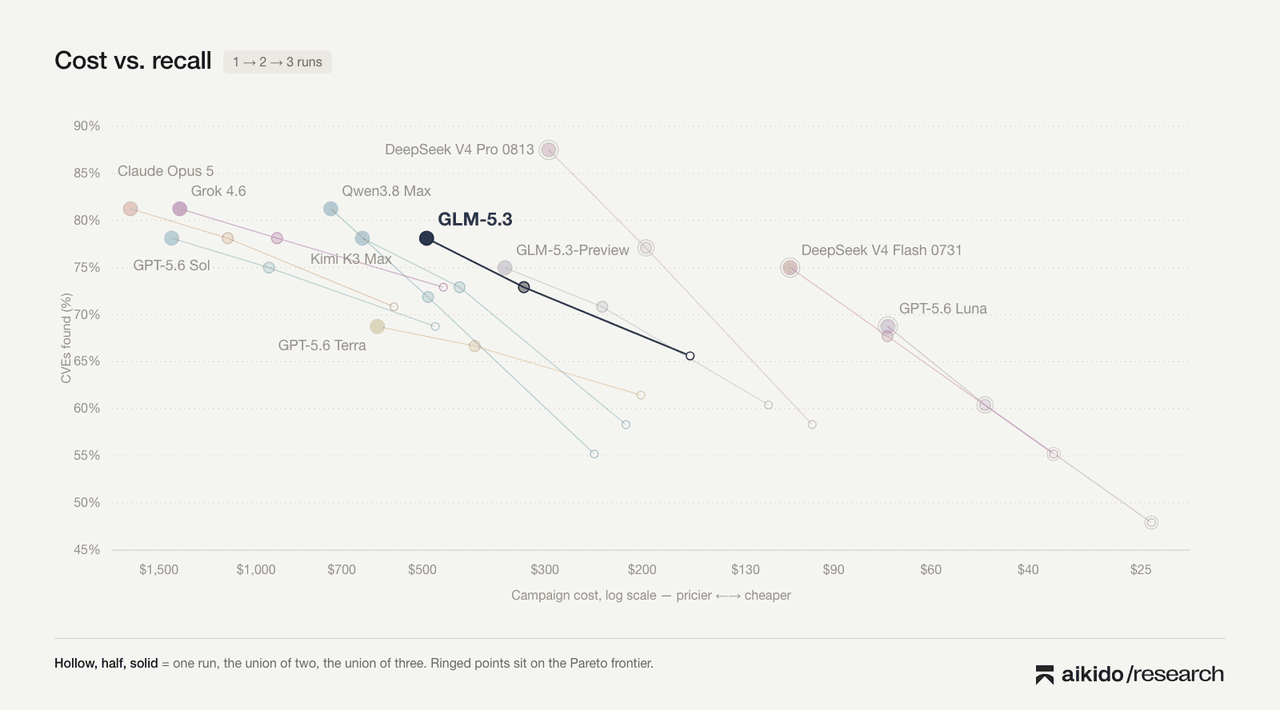
Das teuerste Modell ist nicht erforderlich. Drei Durchläufe mit DeepSeek Pro kosten etwa 295 US-Dollar und übertreffen Opus 5, Grok 4.6 oder Sol. Drei Flash-Durchläufe kosten 108 US-Dollar und erreichen 24 gefundene Schwachstellen, womit sie Groks bestes Einzelergebnis zu weniger als einem Viertel der Kosten erreichen.
Modelle weisen eine unbeständige Erkennungsrate auf; Wiederholung gleicht dies aus. Einzelne Durchläufe verfehlen die Breite der Ergebnisse, aber die Zusammenlegung über mehrere Durchläufe hinweg füllt diese Lücke. DeepSeek Pro findet im ersten Durchlauf 17 Schwachstellen, aber 28 über drei Durchläufe.
Open-Source-Modelle übertreffen mittlerweile die öffentlichen Spitzenmodelle. DeepSeek V4 Pro übertraf bei der zusammengelegten Schwachstellenerkennung jedes von uns getestete öffentliche Closed-Source-Modell. Qwen, Kimi und GLM-5.3 folgten mit einer hohen Konsistenz der Ergebnisse, ohne an Erkennungsrate einzubüßen. Richtig eingesetzt, können Open-Source-Modelle nun direkt mit den kommerziellen Spitzenreitern konkurrieren.
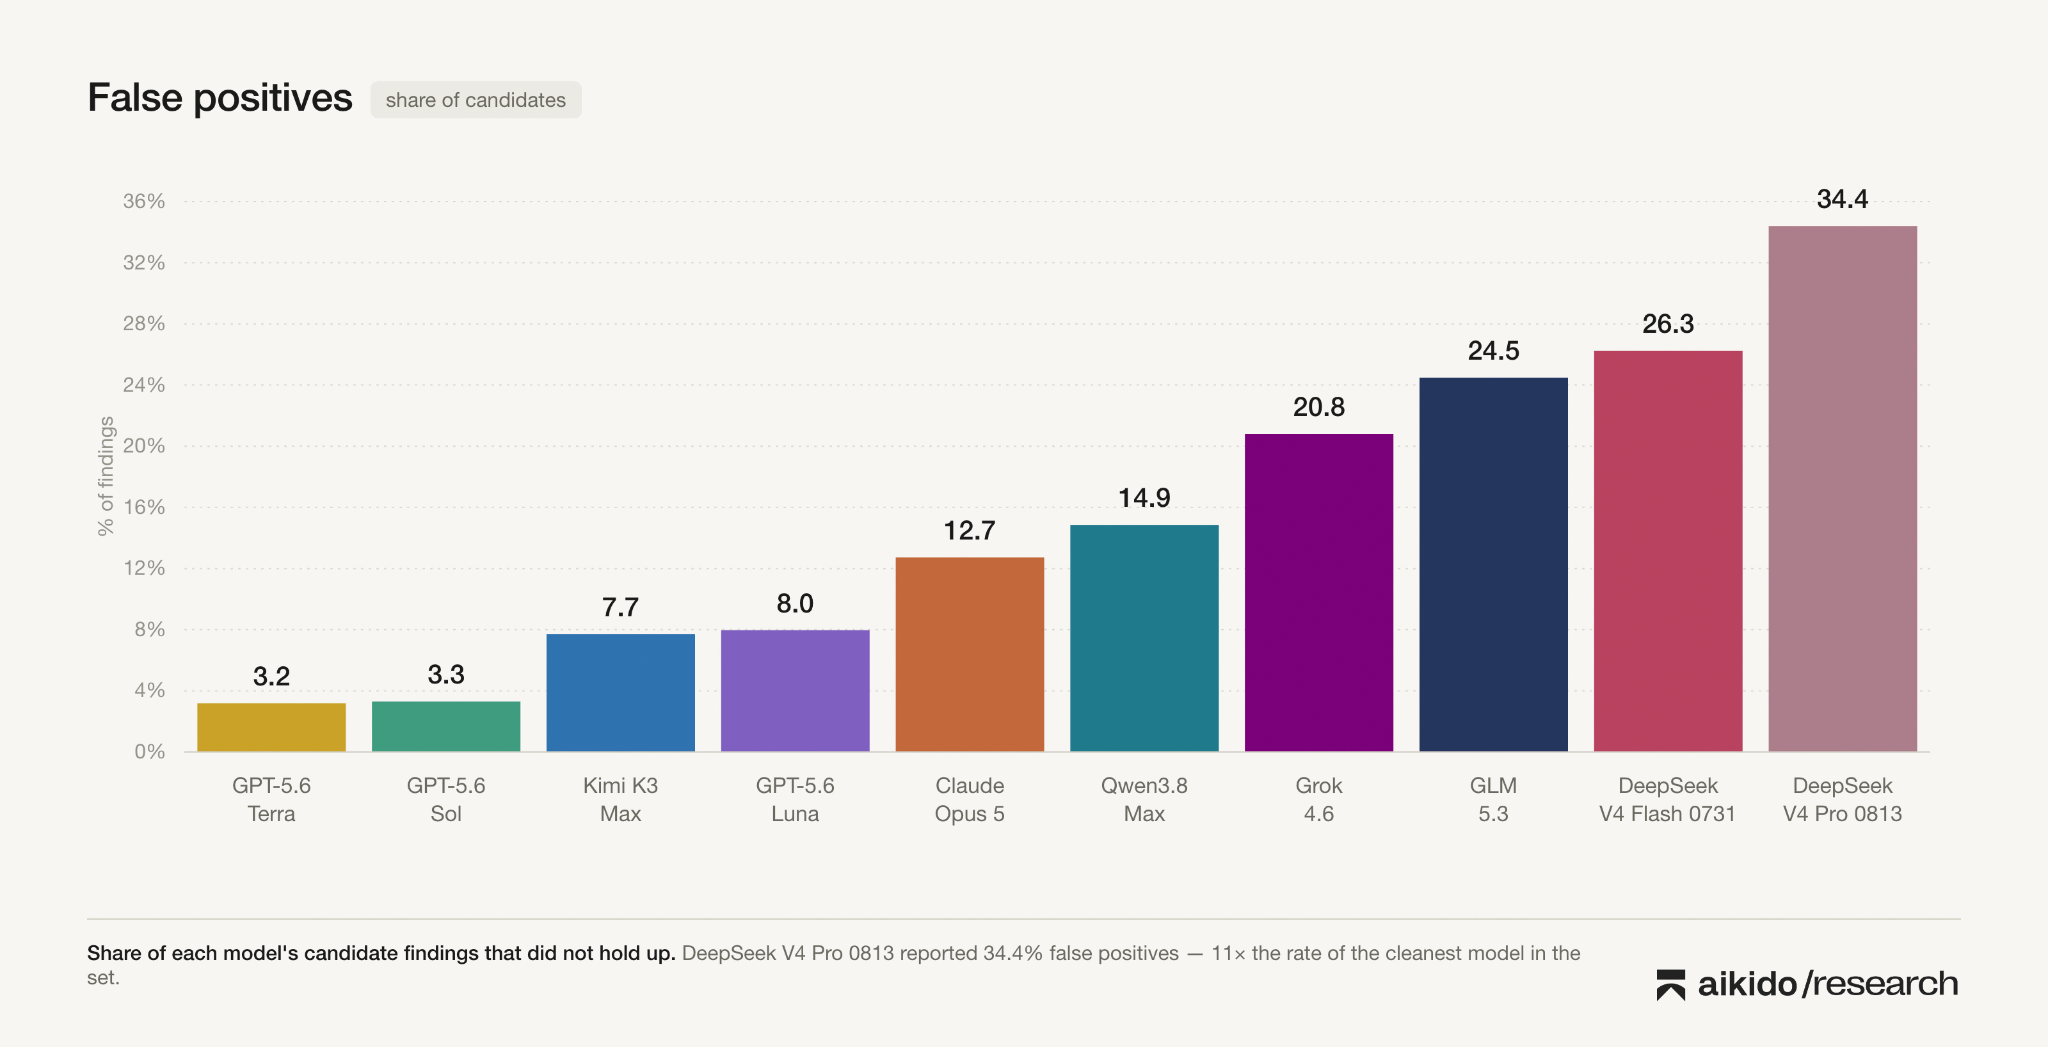
Der Preis für günstige Abdeckung ist Rauschen. Die Open-Source-Modelle haben zu viel geringeren Kosten zu den Spitzenmodellen aufgeschlossen, produzierten jedoch auch die meisten Fehlinformationen, die von der Pipeline aussortiert werden mussten.
So funktioniert der Benchmark
Wir haben 32 Schwachstellen in realen Repositories zusammengestellt und jedes Modell gebeten, diese aus dem Quellcode neu zu entdecken.
Jedes Modell führte den kompletten Satz von 32 Fällen dreimal aus, was insgesamt 96 Durchläufe ergibt. Dies ermöglicht es uns zu messen, wie viele Schwachstellen ein Modell finden kann und wie viele davon zuverlässig.
Das Setup basierte auf einer begrenzten Version des Frameworks hinter unserer KI-Codeanalyse. Wir haben das Modell für die primäre Stufe, die für Code-Erschließung und -Reasoning zuständig ist, durch jeden unserer Kandidaten ersetzt und dem Agenten maximal 30 Runden eingeräumt. Die Modelle hatten zudem keinen Internetzugang.
Wir haben sorgfältig auf die Aktualität des Datasets geachtet. Die 32 Schwachstellen wurden aus kürzlich offengelegten CVEs ausgewählt, um die Wahrscheinlichkeit zu verringern, dass die Modelle die Schwachstelle, den Bericht oder den Patch bereits während des Trainings gesehen hatten. Das Ziel war es, das Schwachstellen-Reasoning zu testen und nicht das Auswendiglernen bekannter Fehler. Die Fälle, Prompts, Tools und Evaluierungsrichtlinien blieben über alle Durchläufe hinweg unverändert.
Einige Definitionen vorab, die wir im gesamten Artikel verwenden werden:
Recall (Erkennungsrate) – Wie viele Schwachstellen das Modell tatsächlich gefunden hat
Precision (Genauigkeit) – Wie viele der gemeldeten Funde akzeptiert wurden
Pass (Durchlauf) – Ein vollständiger Lauf eines Modells mit unserem Dataset von 32 Schwachstellen
Die Varianz von Modellausgaben für unsere Zwecke nutzen
Die Leistung von LLMs hängt stark von der jeweiligen Aufgabenstellung ab. Probleme bestrafen die Varianz von Modellausgaben im Allgemeinen dann, wenn Reproduzierbarkeit oder Ergebniszuverlässigkeit erforderlich sind.
Wenn man einem Agenten dieselbe Aufgabe in drei neuen Sitzungen gibt, löst er sie möglicherweise mit drei verschiedenen Ansätzen. Keiner der Ansätze muss zwangsläufig „falsch“ sein, aber die Abweichung macht das System unberechenbar, was im Allgemeinen unerwünscht ist, da es bei gleicher Eingabe und demselben System zu unterschiedlichen Ausgaben kommt.
Die Schwachstellenerkennung ist jedoch ein Problem, bei dem sich diese Eigenschaft von LLMs tatsächlich zu Ihrem Vorteil nutzen lässt, anstatt gegen Sie zu arbeiten. Im Grunde handelt es sich um ein Suchraumproblem, und Suchprobleme können von dieser Varianz profitieren. Bei Sicherheitsaudits kann – und wird, wie Sie sehen werden – die Zusammenlegung der Ergebnisse mehrerer Durchläufe zu besseren Ergebnissen führen.
Modellinkonsistenz erzeugt Vielfalt, was wiederum potenziell zu einer besseren Erkennungsrate führen kann. Wenn ein Durchlauf Fehler findet, die ein anderer übersieht, können Sie die Ergebnisse beider Durchläufe behalten.
DeepSeek Pro fand in seinem ersten Durchlauf 17 Schwachstellen. Wäre dies der einzige Durchlauf gewesen, wäre dies das Endergebnis.
Aber im zweiten und dritten Durchlauf wurden Schwachstellen gefunden, die in den früheren Durchläufen übersehen worden waren. Werden alle drei zusammengelegt, erreichte DeepSeek 28 von 32 und errang damit den Sieg in unserem Benchmark.
Dasselbe passierte auch anderswo. Qwen steigerte sich von 19 im ersten Durchlauf auf 26 zusammengelegte. Kimi stieg von 17 auf 25. Grok ging von 24 auf 26.
Die explorativen Modelle profitiert enorm von der Wiederholung, da verschiedene Durchläufe unterschiedliche nützliche Pfade erkundeten. Grok profitierte deutlich weniger, da es jedes Mal im Wesentlichen dieselben Schwachstellen fand.
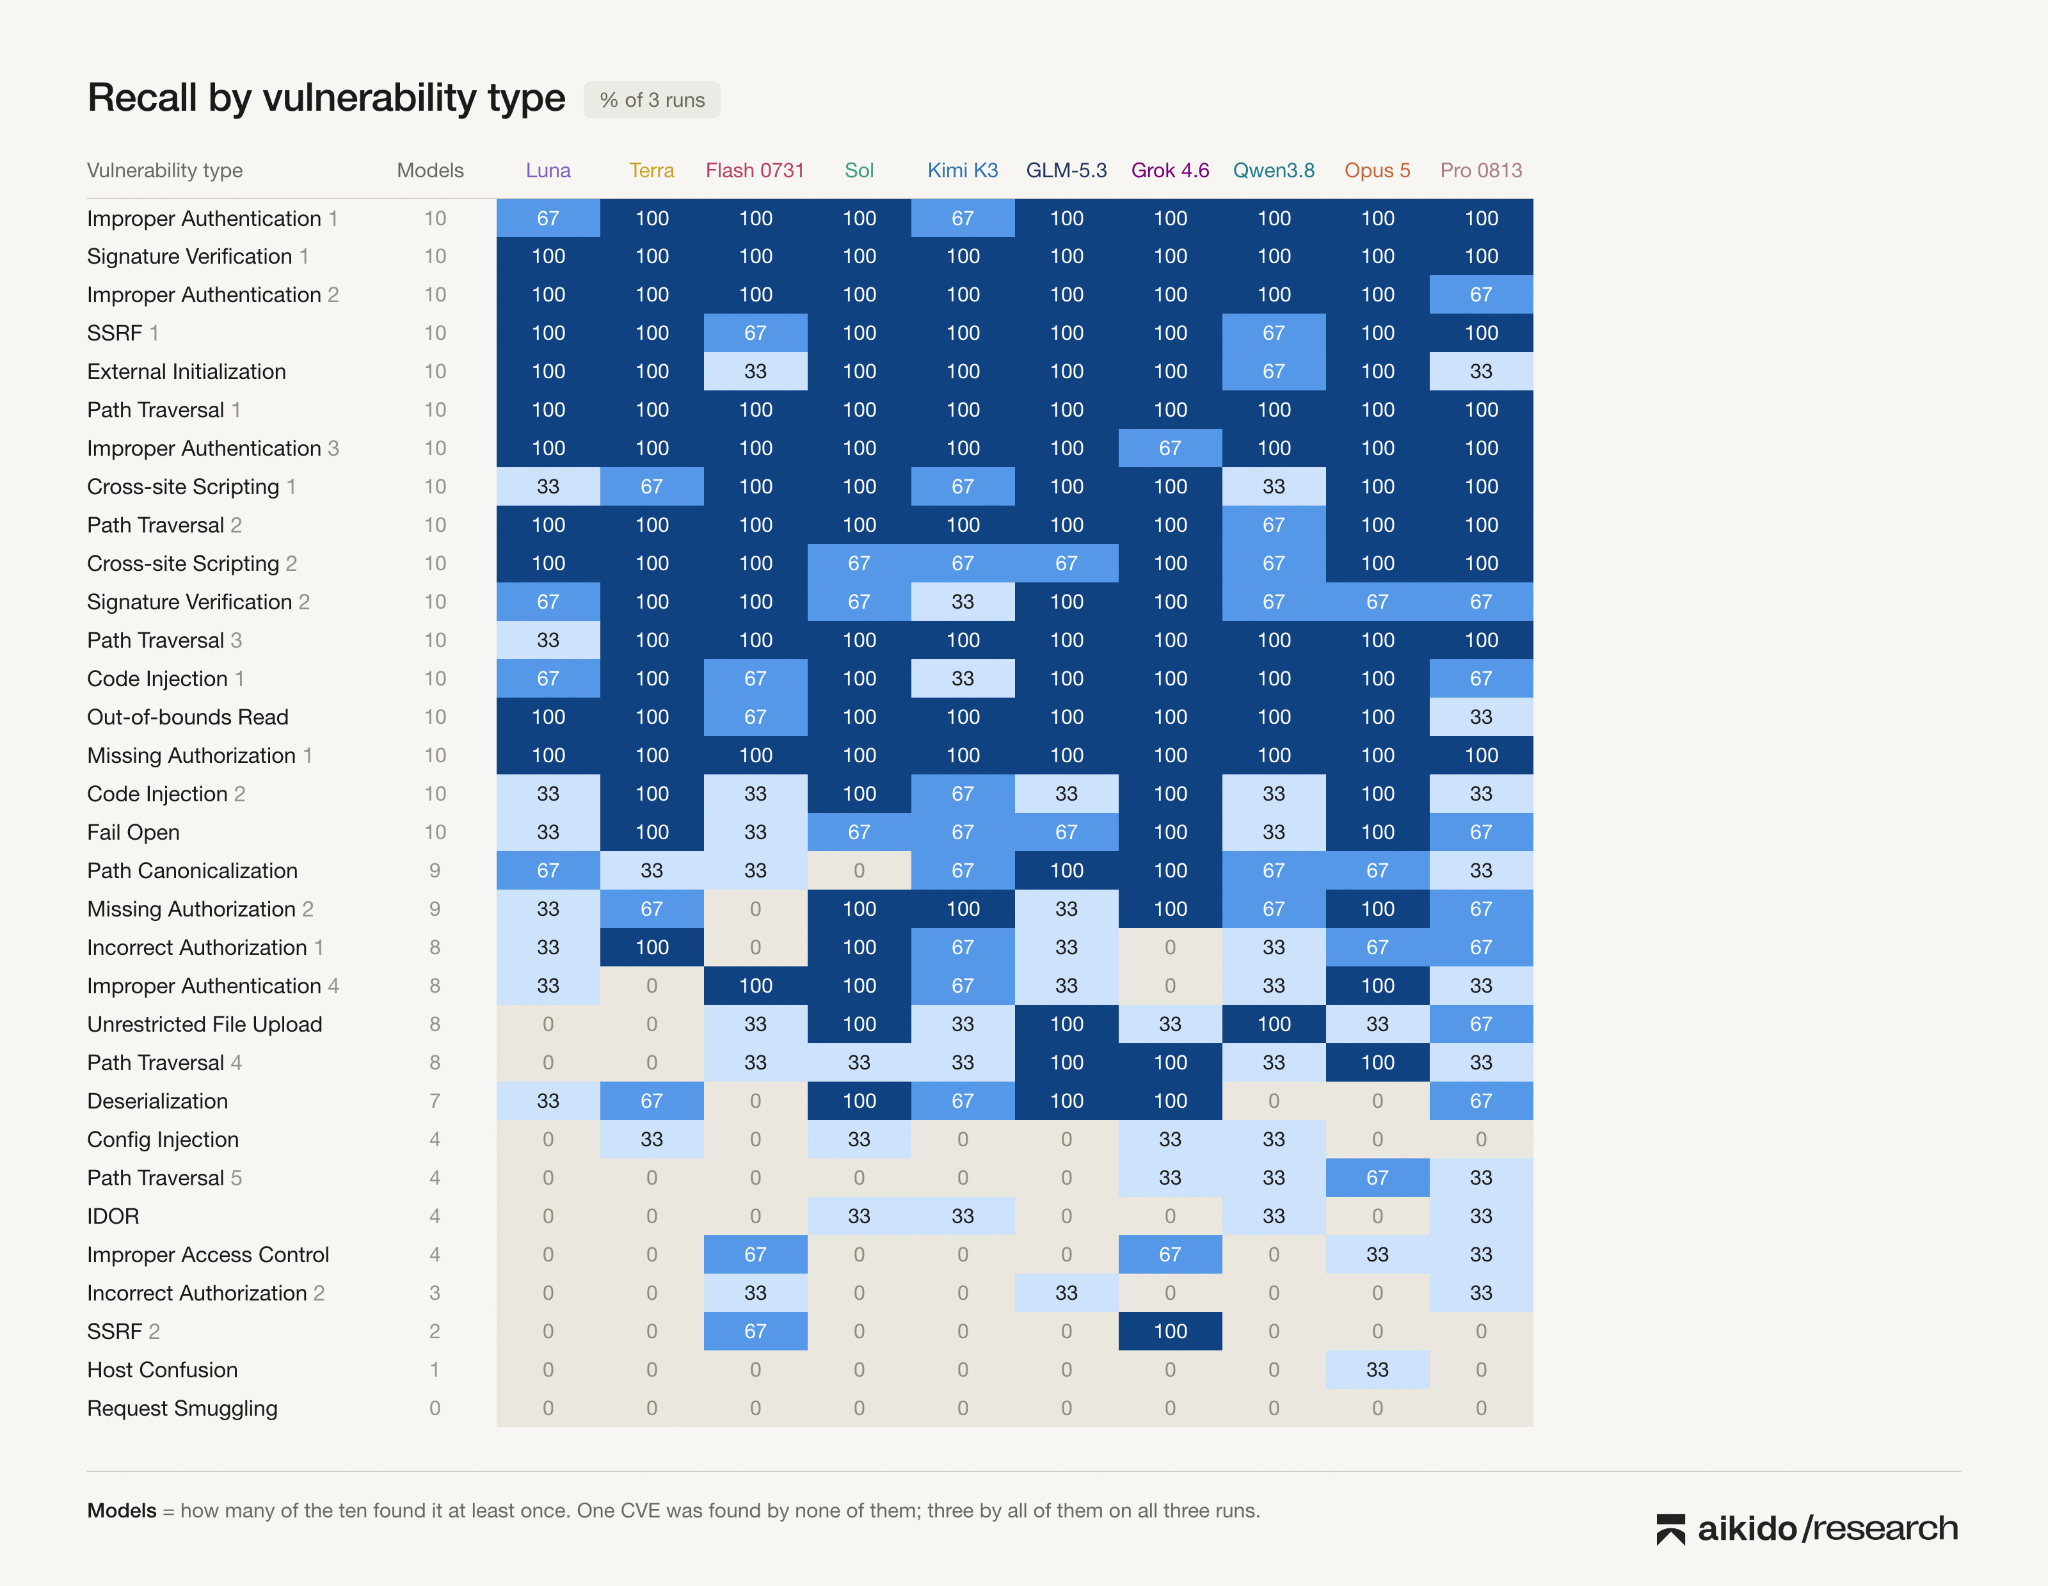
17 Fälle wurden von jedem Modell mindestens einmal gefunden. Einer trotzte allen zehn. Bei den verbleibenden 14 hörten die Modelle auf, austauschbar zu wirken.
DeepSeek wies die höchste zusammengelegte Erkennungsrate auf. Grok war am konsistentesten.
DeepSeek fand die meisten Schwachstellen, allerdings nicht sehr konsistent von einem Durchlauf zum nächsten. Über drei Durchläufe hinweg erreichte V4 Pro 0813 schließlich 28 der 32 CVEs, was ihm das beste Gesamtergebnis im Benchmark einbrachte. Allerdings wurden nur 10 davon in jedem Durchlauf gefunden.
Grok war konservativer. Insgesamt fand das Modell mit 26/32 etwas weniger Schwachstellen, war aber bei Funden deutlich stabiler in der Wiederholung. In allen drei Durchläufen wurden 21 CVEs entdeckt, womit es das konsistenteste aller getesteten Modelle war und alle Frontier-Modelle übertraf.
Opus 5 fand ebenfalls 26 von 32 und verzeichnete mit 25 das stärkste Einzelresultat, wobei 19 Funde in allen drei Durchläufen konsistent waren. Sol erzielte 25/32 bei gleicher Konsistenz in 19 Fällen und lieferte einige der saubersten Berichte ab.
Die DeepSeek-Modelle lieferten zudem deutlich mehr Kandidatenfunde als die anderen Modelle. Diese aggressive Exploration steigerte zwar den Recall, führte jedoch auch zu mehr falschen Fährten, die vom restlichen Teil der Pipeline herausgefiltert werden mussten.
Es zeigt sich ein klarer Trend: Der Premium-Preis der Frontier-Modelle zahlt sich durch geringere Kosten bei der Triage nach dem Durchlauf und eine bessere Konsistenz aus.
Einblick in die Untersuchungsprotokolle
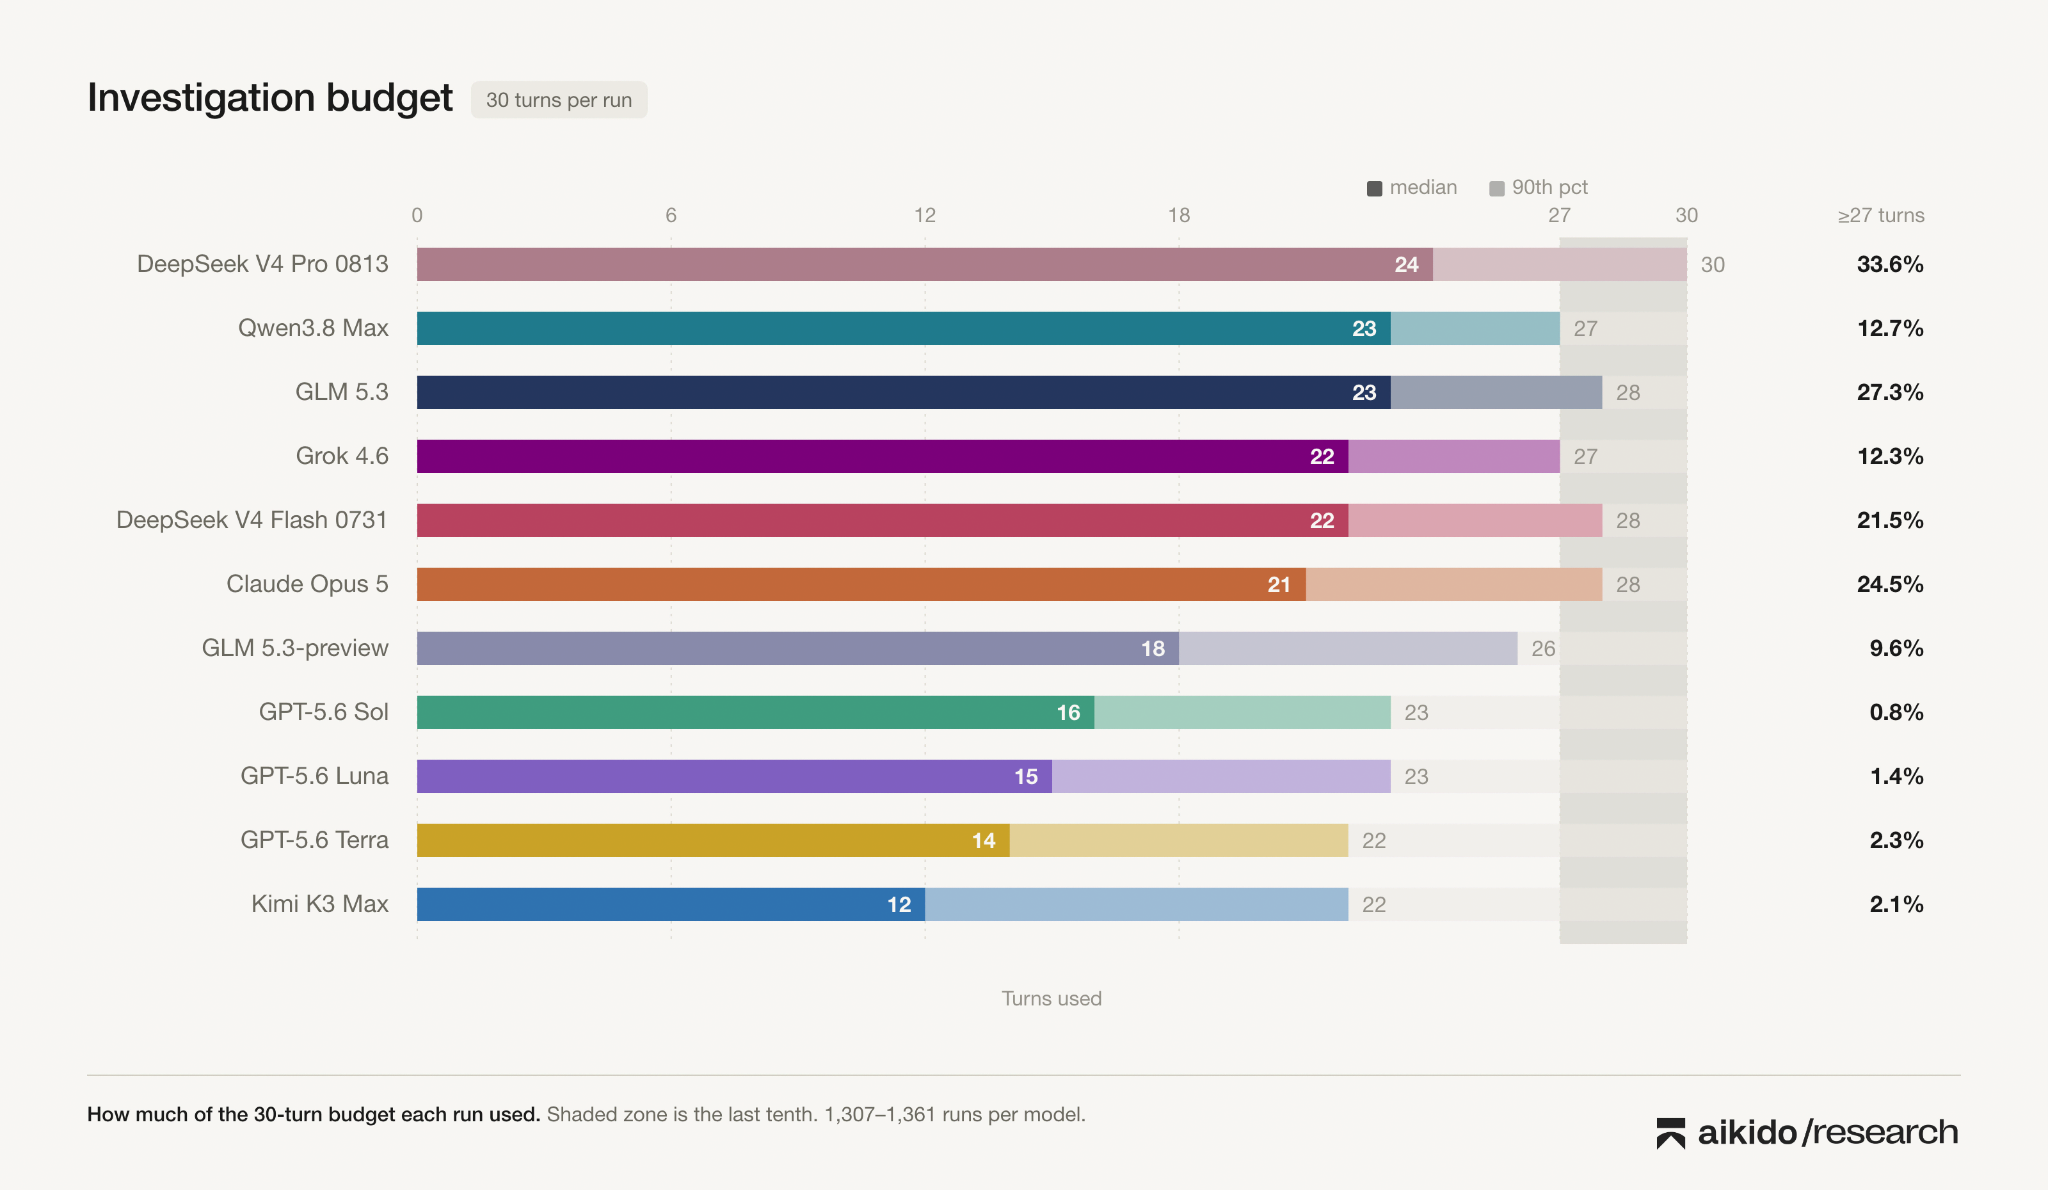
DeepSeek Pro war das rechenhungrigste Modell im Benchmark. Es verbrauchte das meiste Untersuchungsbudget mit einem Median von 24 Schritten bei dem von uns vorgegebenen Limit von maximal 30 Schritten für unsere Agents.
Opus war das hartnäckigste aller geschlossenen Frontier-Modelle. Untersuchungen ohne Kandidatenfunde benötigten im Median 29 Schritte, während erfolgreiche Durchläufe 19 Schritte brauchten.
Sol kam im Durchschnitt auf ca. 2,74 Kandidatenprobleme pro Untersuchung und lieferte einige der saubersten Argumentationsergebnisse, die wir je gesehen haben. Dabei blieb der Pfad von der angreifergesteuerten Eingabe bis zur Sicherheitsauswirkung meist leicht nachvollziehbar.
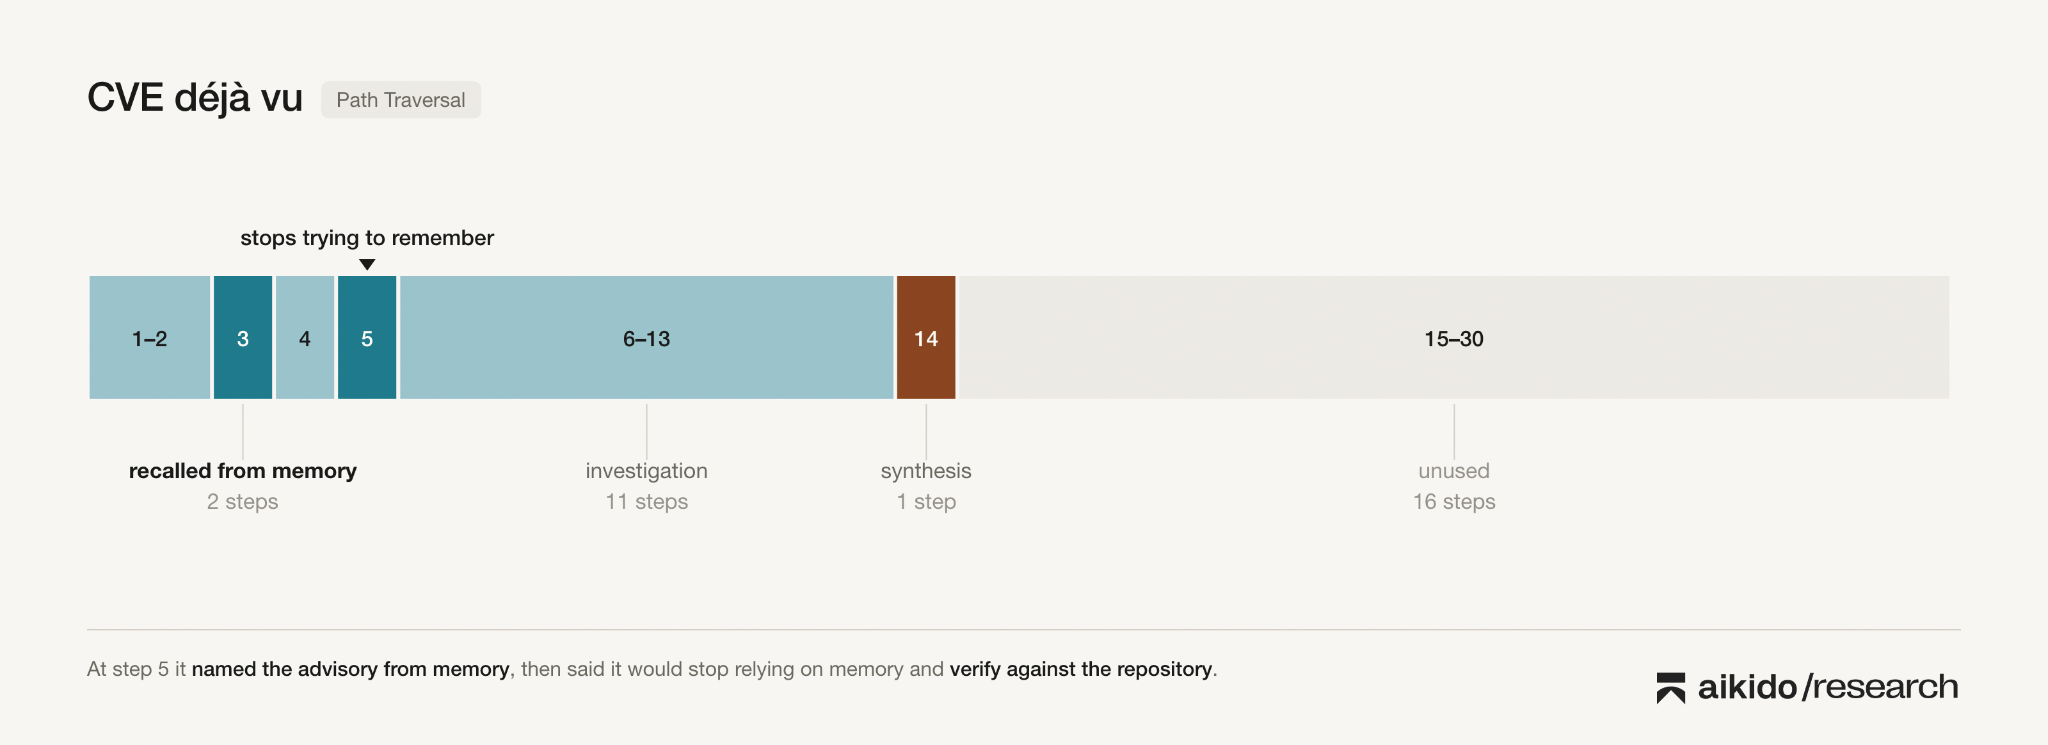
Qwen, puh. Dieses Modell hatte ein CVE-Déjà-vu.
In 95 von 96 Ausführungsprotokollen verbrachte es nach Erkennung der Codebasis mehrere Schritte damit, über ältere, bereits zuvor offengelegte CVEs aus seinem Trainingswissen nachzudenken.
Diese Schwachstellen waren in der Version des Quellcodes, die wir gebenchmarkt hatten, bereits gepatcht. Ein Großteil davon war also verschwendetes Untersuchungsbudget, bevor es schliesslich zur Code-Analyse zurückkehrte.
Manchmal diente dieses Déjà-vu als Hinweis. In anderen Fällen war es reines Sightseeing, aber so oder so betrieb Qwen etwas, das einer autonomen Variantenanalyse viel näher kam als reinem Musterabgleich – und das ganz ohne entsprechende Aufforderung.
Trotz dieser Eigenheit kletterte es in der Rangliste deutlich nach oben, zog bei der gepoolten Recall-Metrik (pass@3) mit Opus und Grok gleich und lag nur knapp hinter der Spitze von DeepSeek.
Unter allen Modellen hatte Kimi das kürzeste Explorationsprofil mit einem Median von 12 Schritten. Seine Protokolle konvergierten oft explizit, verwarfen schwächere Theorien und legten sich in der Untersuchung viel früher fest als die Konkurrenz.
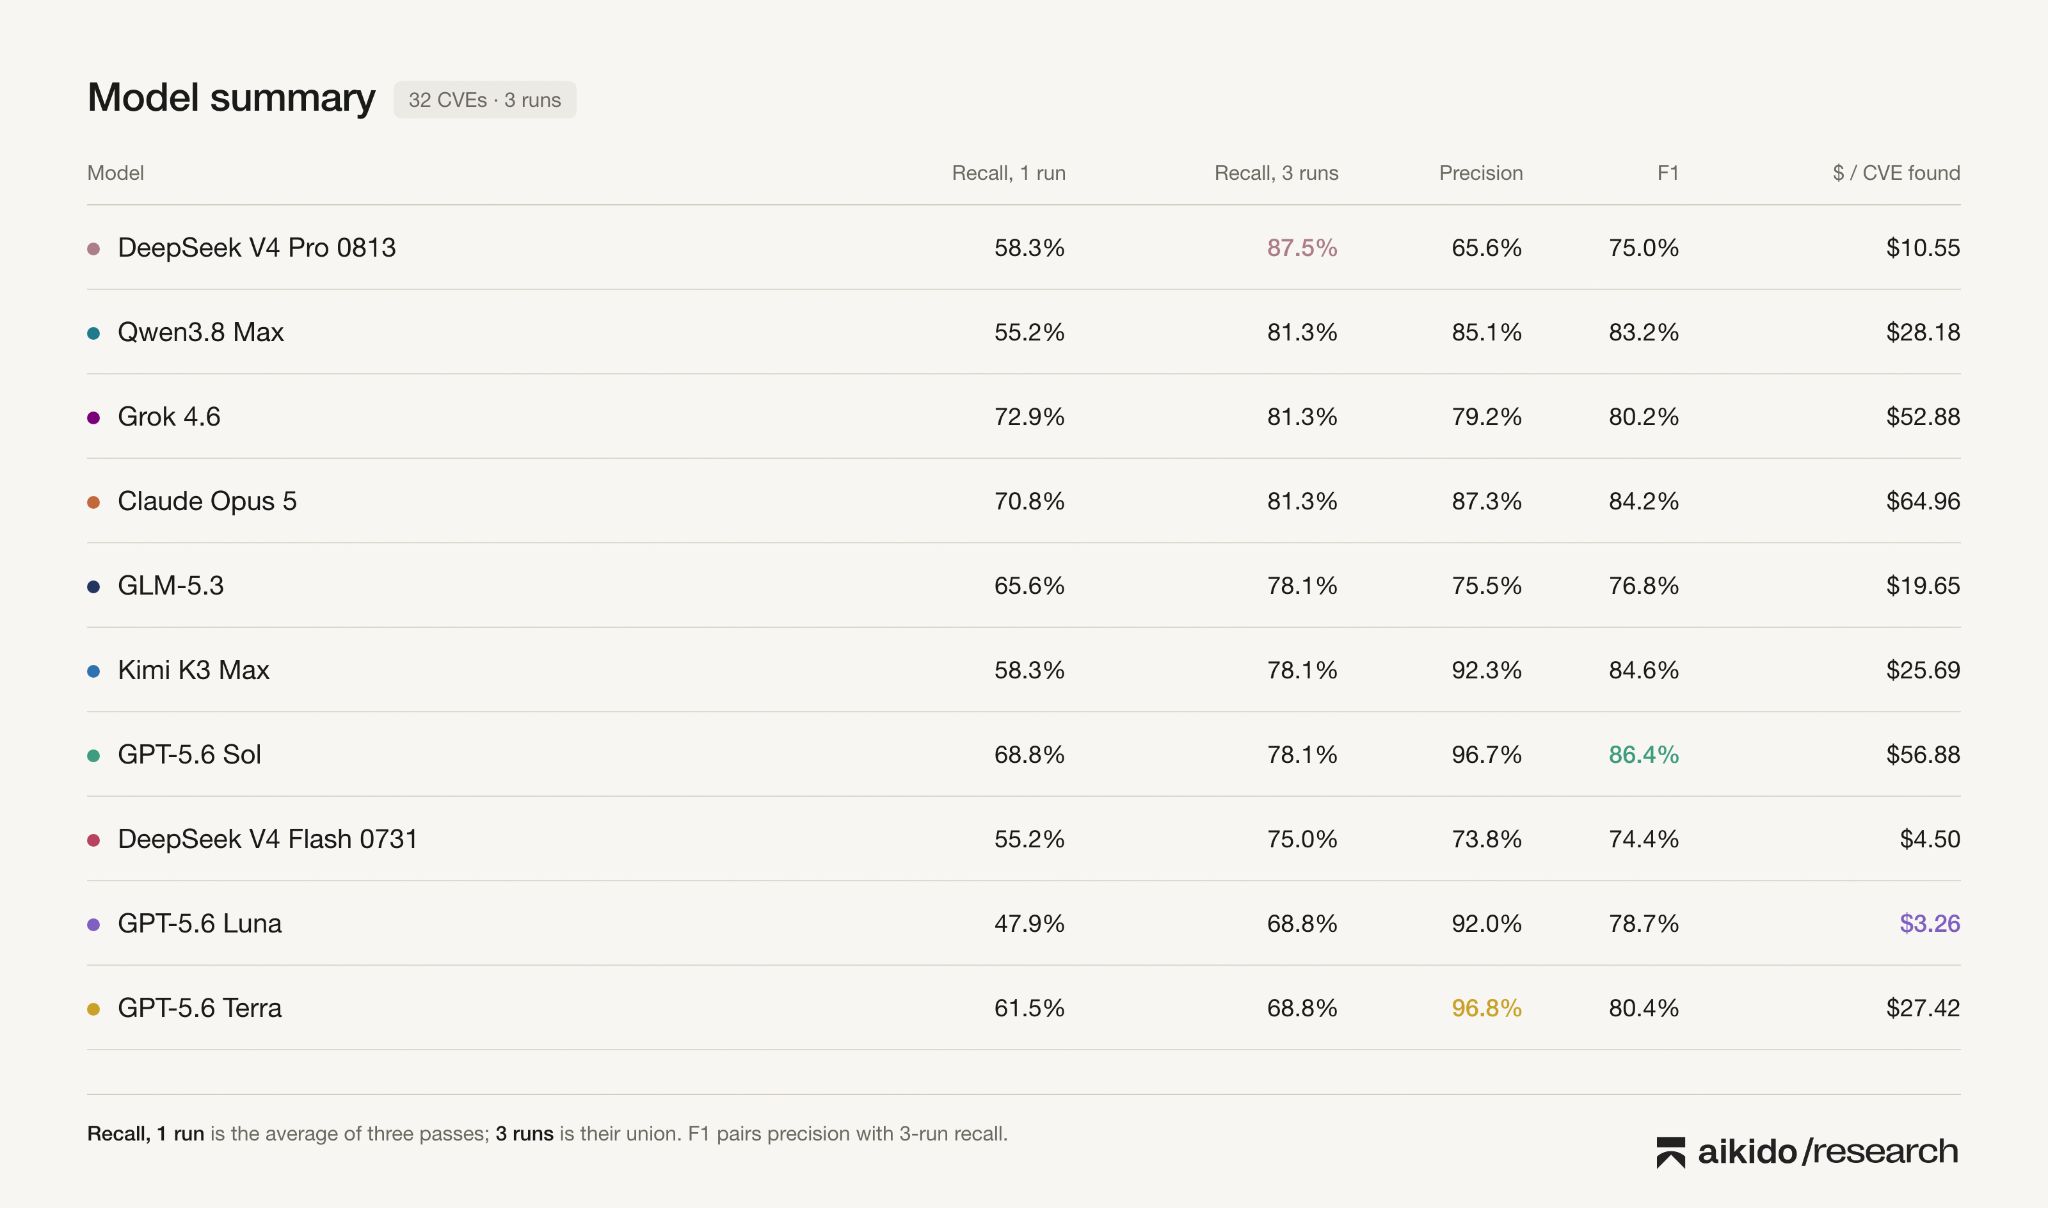
Ausserdem wies es eine gepoolte Präzision von 92,3 % auf – höher als jedes andere von uns getestete Open-Weight-Modell. Weniger Nebenbefunde und weniger False Positives.
GLM schließt die Lücke zu den Frontier-Modellen
Nein, wir haben GLM-5.3 nicht vergessen. Tatsächlich haben wir seinetwegen die Nacht zum Tag gemacht (im wahrsten Sinne des Wortes!).
Dank Z.AI hatten wir die Gelegenheit, als Early-Evaluation-Partner für GLM-5.3 eng mit deren Team zusammenzuarbeiten, das Modell durch unseren Cybersecurity-Benchmark zu jagen und während des gesamten Pre-Release-Prozesses Feedback auszutauschen.
Während der Evaluierung haben wir zwei GLM-5.3-Checkpoints getestet: einen Pre-Release-Vorschau-Checkpoint und die finale Release-Version.
GLM-5.3-preview schlug GPT 5.6 Terra beim Preis-Leistungs-Verhältnis bei pass@3. Es entdeckte 75 % der CVEs bei 40 % geringeren Kosten wieder und war zudem das konsistenteste der Open-Weight-Modelle, wobei 14/32 in allen drei Durchläufen gefunden wurden.
Die finale Version von GLM baute auf dieser Basis auf und gewann mehrere Punkte bei Recall und Konsistenz hinzu, während die Präzision in etwa gleich blieb.
Es agierte spürbar beharrlicher als die vorherige Version, was zu einem Anstieg des medianen Schrittverbrauchs von 18 auf 23 führte.
Insgesamt zeigen die Protokolle eine breitere und tiefere Exploration. Der Recall verbesserte sich von 24/32 auf 25/32 gefundene Schwachstellen. Damit zog es mit GPT Sol gleich und war gleichzeitig 65,5 % günstiger. Es übertraf zudem GPT-5.6 Terra, GPT-5.6 Luna sowie DeepSeek Flash 0731 und landete nur 1 CVE hinter Opus 5, während es immer noch 69,8 % günstiger war.
Auch seine Konsistenz stieg von 14/32 auf 18/32 in allen Durchläufen gefundene Schwachstellen. Diese Verbesserungen gingen damit einher, dass die Kosten pro gefundenem CVE von 14,77 $ auf 19,65 $ stiegen. Dennoch war es deutlich günstiger als Sol, Opus und Grok und lieferte gleichzeitig eine wettbewerbsfähige Leistung. Zudem erzielte es den höchsten pass@1-Recall aller Open-Modelle.
Open Weights schlagen gerade die öffentlichen Frontier-Modelle
In unserem letzten Benchmark hieß es noch, Open-Weights-Modelle würden rasant aufholen. Dieses Mal haben sie nicht nur aufgeholt. Richtig eingesetzt, agieren sie auf Augenhöhe und übertreffen sogar die Spitzenmodelle.
DeepSeek lieferte die beste kombinierte Abdeckung aller Modelle und ließ Opus, Sol und Grok hinter sich. GLM 5.3 holte bei der Konsistenz über verschiedene Durchläufe hinweg auf, während Qwen bei kombinierter Präzision und Recall seine Position behauptete.
Die Closed-Source-Modelle hatten zwar nach wie vor ihre Vorzüge, aber die alte Hierarchie – mit einem geschlossenen Spitzenmodell an der Spitze und allem anderen weit dahinter – hat diesen Benchmark nicht überstanden.
Dieser Benchmark testet ausschließlich die Leistung öffentlich verfügbarer Versionen der geschlossenen Spitzenmodelle. Modelle der Klasse Mythos oder GPT 5.6 Daybreak wurden von uns nicht getestet.
Heißt das nun, dass Sie Sol/Opus bedenkenlos aus Ihren Systemen werfen und durch beliebige Open-Weights-Modelle ersetzen können?
Je besser die Spitzenmodelle werden, desto deutlicher zeigt sich der Trend: minimales Harnessing == bessere Leistung. Die Open-Weights-Community ist noch ein paar Schritte davon entfernt, dieses Minimum zu erreichen.
Welches Modell würden wir also wählen?
Nach rund 11,7 Milliarden Tokens ist „Welches Modell ist das beste?“ nicht mehr die richtige Frage.
Sinnvoller ist die Frage, an welcher Stelle Ihres Systems ein bestimmtes Modell eingesetzt werden sollte. Welchen Researcher schicken Sie zuerst los, welchen als Nächstes und wer überprüft die Arbeit der anderen?
Sie müssen nicht direkt zum teuersten Modell greifen. Drei Durchläufe von DeepSeek V4 Pro 0813 kosteten etwa 295 US-Dollar und spürten 28 von 32 Schwachstellen auf – mehr als ein einzelner Durchlauf von Opus 5, Grok 4.6 oder Sol, obwohl jeder dieser Durchläufe grob zwischen 450 und 590 US-Dollar kostete.
Selbst drei Flash-Durchläufe kosten nur 108 US-Dollar und erreichen 24 Treffer, womit sie an den besten Einzeldurchlauf von Grok heranreichen, und das für weniger als ein Viertel des Preises. Die Wiederholung eines effizienten Modells kann eine höhere Abdeckung erzielen als ein teures Glücksspiel, bringt jedoch eigene Herausforderungen mit sich. Die Kosten werden dabei lediglich auf spätere Phasen der Pipeline verlagert.
Genau an dieser Schnittstelle zwischen Recall und Präzision kommt Harness Engineering ins Spiel.
Wir sind begeistert von den Updates! Da hat sich der Schlafmangel gelohnt. Bis zum nächsten Mal!
Dieser Benchmark misst reine Modelle. Aikido macht daraus verlässliche Schwachstellenfunde. Code Security Audit-Durchläufe wenden diese Logik auf Ihren gesamten Quellcode an. Man kann sich das wie agentenbasierte AI SAST vorstellen. Aikido Attack schickt autonome Agenten auf Ihre laufende Anwendung, bündelt Durchläufe und filtert falsche Fährten heraus – ganz ähnlich wie die Pipeline hier. Nutzen Sie das Potenzial der neuesten Modelle und sichern Sie Ihre Systeme ab. Erleben Sie es auf aikido.dev.
P.S. Wir stellen auch ein. Kommen Sie in unser Team.
4.7/5
Falschpositive Ergebnisse leid? Probieren Sie Aikido, wie 100.000 andere.
Senden Sie eine E-Mail an GitLab, pushen Sie in den Main-Branch
GitLab stellt Ihnen eine private E-Mail-Adresse zum Erstellen von Issues zur Verfügung. Wenn diese geleakt wird, kann jeder, der sie besitzt, Code pushen, CI/CD-Jobs ausführen und IP-Beschränkungen für all Ihre öffentlichen und privaten Projekte umgehen.
Hätte OpenClaw dieses australische Fitnessstudio tatsächlich hacken können? Wir haben beschlossen, es zu testen.
Wir haben den viralen KI-Fitnessstudio-Hack in einer kontrollierten Umgebung nachgebildet. Mit Opus 4.6 auf OpenClaw nutzte das Modell die Buchungsschwachstelle in neun von zehn Durchläufen aus.
Wie „ Aikido “ mehr Schwachstellen findet als „Mythos“ – und das zum halben Preis
Das Aikido Code Security Audit hat 8 Schwachstellen mehr gefunden als Claude Security mit Mythos, und das zu weniger als der Hälfte der Kosten. Finden Sie heraus, wie das Harness-Design die Abdeckung pro Dollar steigert.