

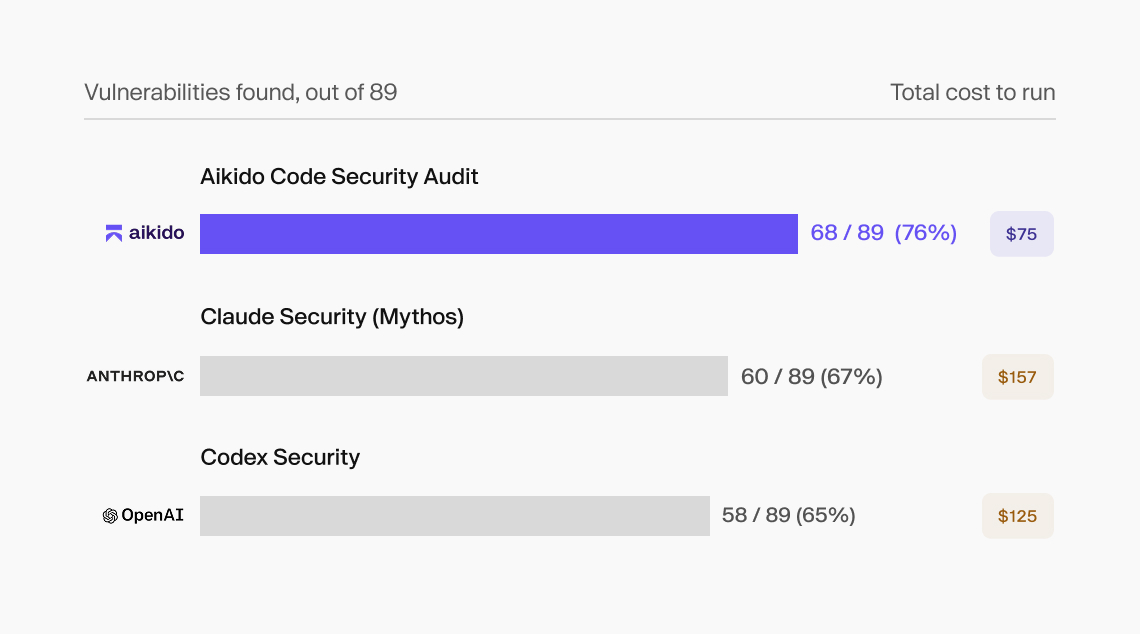
TL;DR: Wir haben drei KI-Code-Sicherheitsprodukte anhand einer privaten Benchmark-App mit 89 bekannten Schwachstellen getestet. Hier sind die Ergebnisse:
- Aikido Code Security Audit: 68 von 89 Schwachstellen (76 %) für 75 $
- Claude Security mit Mythos: 60 von 89 Schwachstellen (67 %) für 157 $
- Codex Security: 58 von 89 Schwachstellen (65 %) für 125 $
Claude Mythos ist wohl das stärkste Cybersecurity-Modell, das Anthropic bisher entwickelt hat. Wir wissen jedoch, dass die Leistungsfähigkeit des Modells nur ein Teil des Faktors ist, der bestimmt, wie gut ein KI-Schwachstellenprodukt abschneidet.
Um das zu testen, haben wir Anthropics Claude Security (das auf Mythos läuft) und Aikido Code Security Audit direkt gegeneinander antreten lassen, um zu sehen, welche Lösung die beste Abdeckung zu welchen Kosten liefert. Code Security Audit ist Teil der Suite Aikido AI-Codeanalyse. Wir haben auch Codex Security getestet. Wir haben alle drei Produkte gegen dieselbe private Benchmark-Anwendung laufen lassen.
Das Ergebnis? Aikido fand 8 Schwachstellen mehr als Claude Security mit Mythos – darunter 1 kritisches und 3 schwerwiegende Probleme – und das bei weniger als der Hälfte der Kosten. Aikido fand sogar ganze zehn Schwachstellen mehr als Codex Security. Diese Ergebnisse sind ein weiteres Beispiel dafür, dass Leistung und Effizienz vom System um das Modell herum abhängen; selbst mit dem fähigsten Modell kann die Performance andernfalls zurückbleiben.
Das Drumherum macht nach wie vor den Unterschied
Wie wir bereits geschrieben haben, ist die Entdeckung von Schwachstellen im Grunde ein Suchproblem. Ein Tool muss entscheiden, wo es sucht, welchen Hypothesen es nachgeht, wie tiefgehend es diese untersucht und wann ein Fund über ausreichend Belege verfügt, um ihn zu melden.
Claude Security verwendet einen komplexen Prozess, der Repository-Mapping, Scanning-Agenten und mehrstufige Verifizierung umfasst. Aikido verfügt über einen eigenen ausgeklügelten Prozess, unterscheidet sich jedoch in der Zuweisung dieser Arbeit: Es werden kostengünstigere, kleinere Modelle eingesetzt, die gezielt für die Aufgaben ausgewählt werden, die sie am besten beherrschen. Diese kleineren Modelle können ein breiteres Spektrum unabhängiger Hypothesen untersuchen, während teures Frontier-Reasoning den Phasen vorbehalten bleibt, in denen es am ehesten einen Unterschied beim Ergebnis bewirkt.
Genau diese Zuweisung hat es diesem Durchlauf ermöglicht, das Budget für die Untersuchungsbreite aufzuwenden, anstatt das teuerste Modell auf alles anzusetzen, was zu einem wesentlich höheren Recall (Trefferquote) geführt hat.
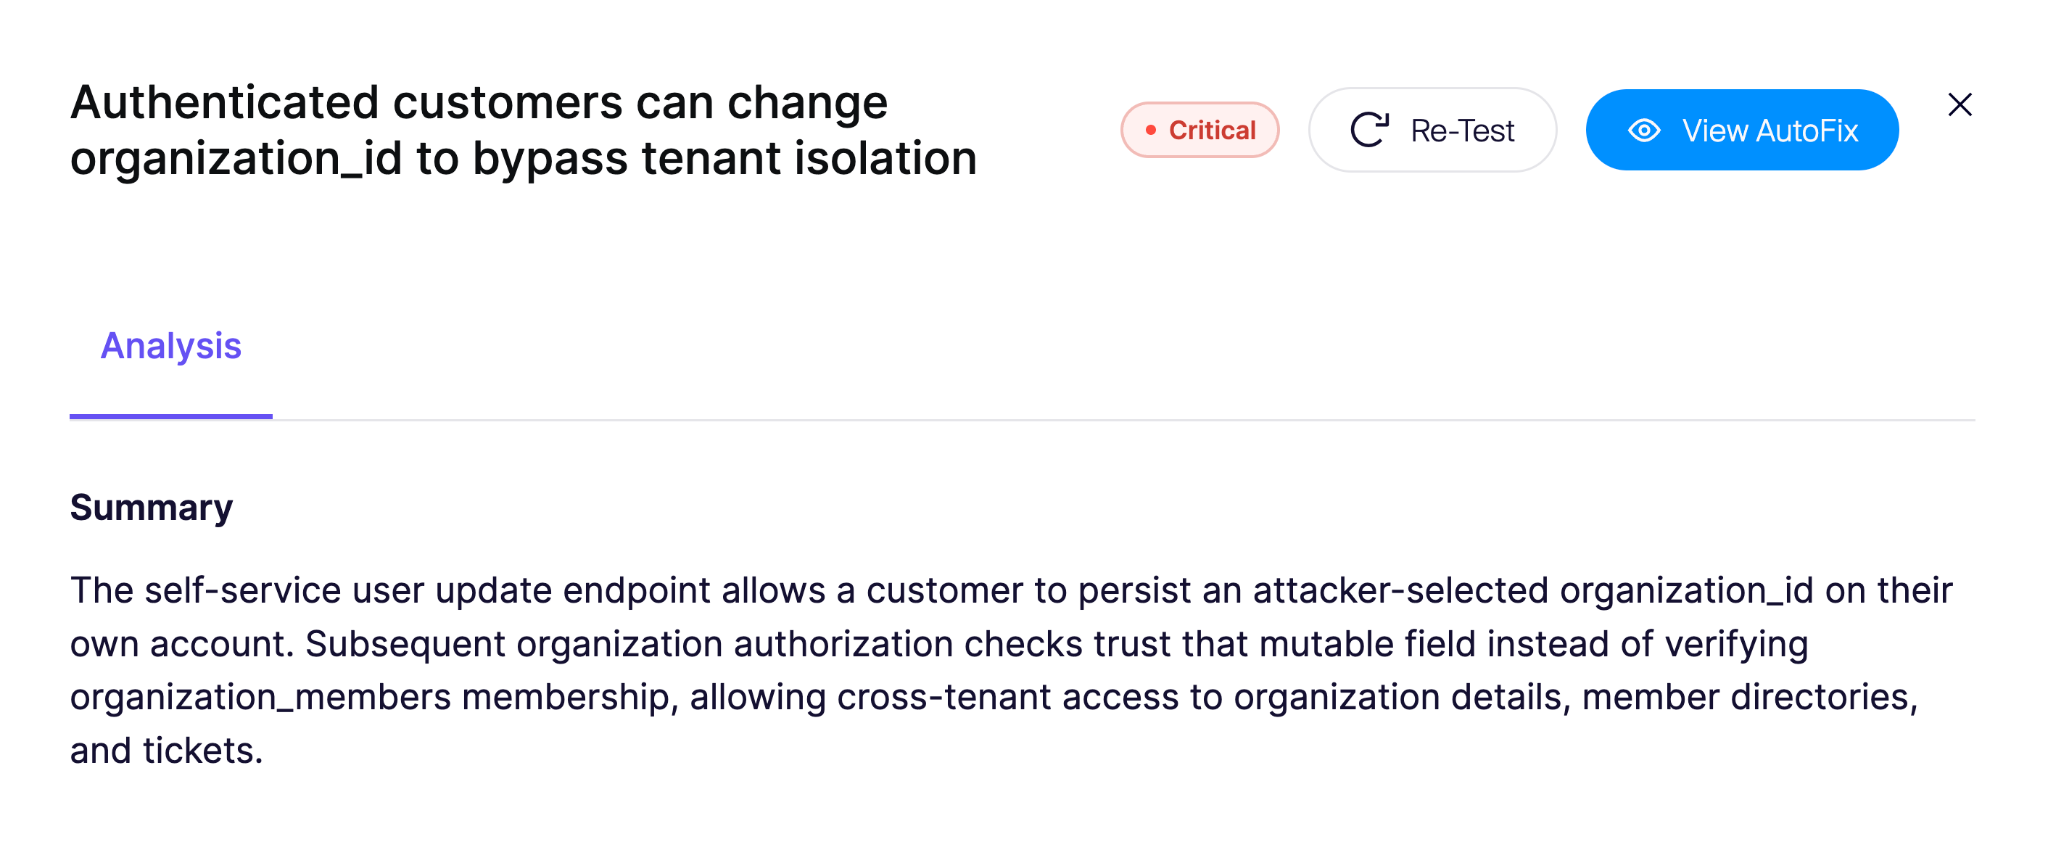
Dieser höhere Recall umfasste mehrere Probleme mit realen Auswirkungen, die Aikidos Schwarm von Agenten aufdeckte, während Mythos sie übersah. Eines war ein kritischer Cross-Tenant-Autorisierungsfehler, der es Benutzern ermöglichte, ihre eigenen Kontoeinstellungen zu aktualisieren und ihre Organisationszuweisung zu ändern, um sich selbst zu einer anderen Organisation hinzuzufügen. Dadurch erhielten sie Zugriff auf die Daten dieser Organisation. Aikido fand zudem subtilere und leicht zu übersehende Probleme, darunter eine Diskrepanz im Zeitstempelformat zwischen Anwendung und Datenbank, durch die abgelaufene API-Schlüssel gültig blieben.
Spitzentechnologie im Bereich der Intelligenz wird schnell teuer
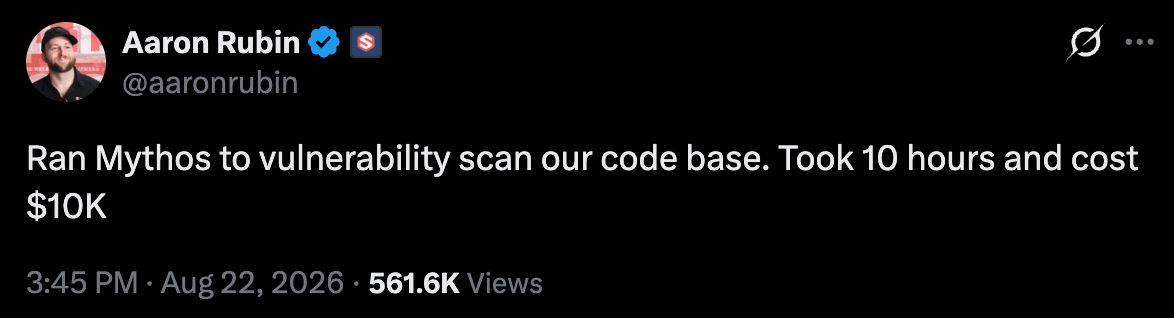
Mythos beginnt bei 10 $ pro Million Eingabe-Token und 50 $ pro Million Ausgabe-Token. Das summiert sich schnell, wenn sich ein Review über Hunderte von Agenten-Trajektorien in einem großen Repository erstreckt.
Das Problem ist, dass agentenbasierte Code-Audits kein festes Arbeitsvolumen haben. Abhängig von Faktoren wie Repository-Größe und Anwendungskomplexität variieren die Anzahl der zu verfolgenden Spuren und das erforderliche Reasoning von Repository zu Repository.
Claude Security überlässt Ihnen diese Variabilität. Anwender fliegen im Blindflug, da Claude Security Ihnen die Kosten des Scans erst anzeigt, wenn der Lauf bereits beendet ist. Wenn sich der Staub legt, kann am Ende also ein wesentlich höherer Preis als erwartet herauskommen.
Aikido entscheidet sich für einen anderen Weg. Wir tragen diese Ungewissheit selbst. Bevor der Scan beginnt, schätzen wir dessen Kosten anhand der Repository-Größe, des überprüfbaren Codes und der Komplexität dynamisch ab und zeigen dem Benutzer diese Schätzung an.
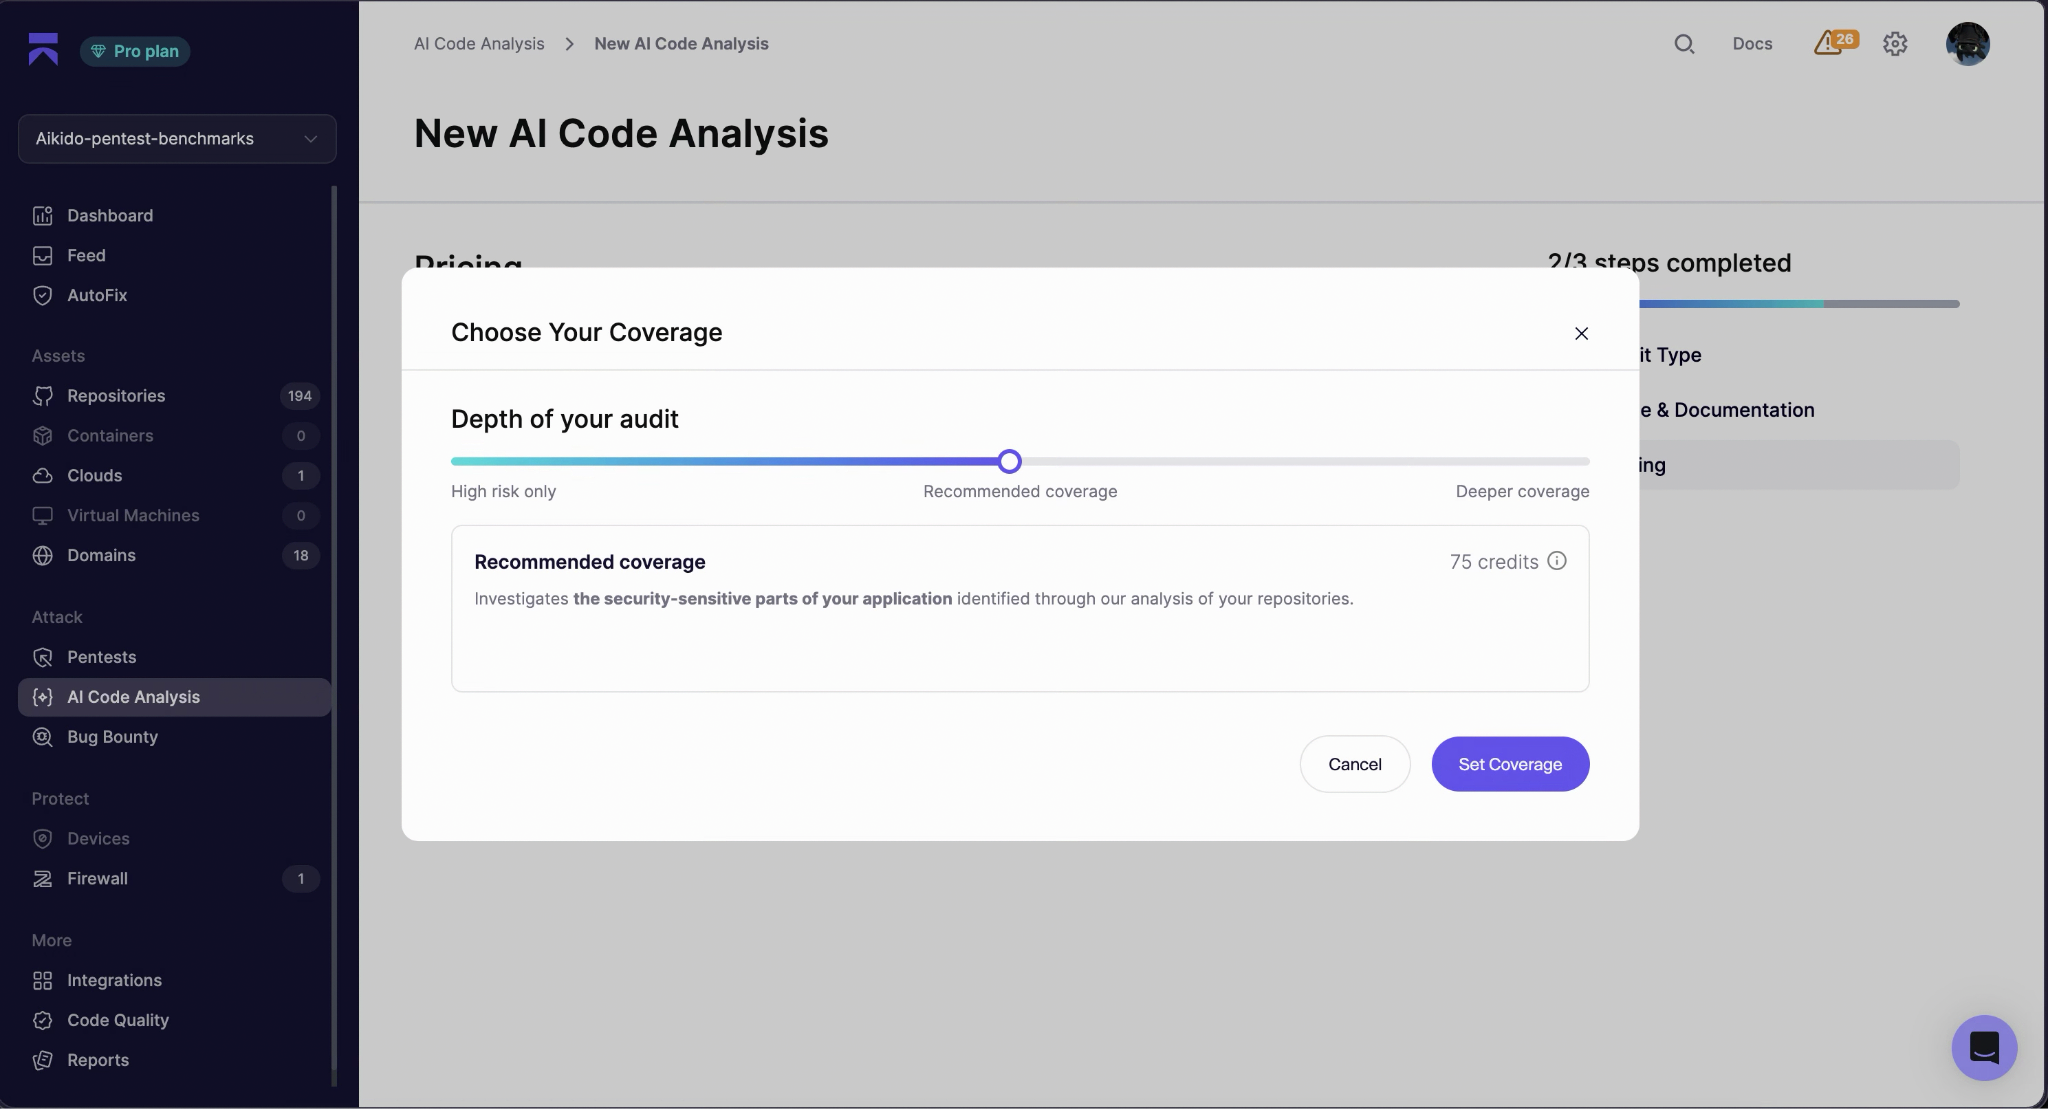
Als Benutzer können Sie das Abdeckungsniveau an diese Schätzung anpassen (es erhöhen oder senken), bevor Sie sie bestätigen. Unser Durchlauf im Benchmark-Repository hätte Sie bei empfohlener Tiefe 75 $ gekostet, während Claude Security pauschal mit 157,06 $ zu Buche geschlagen wäre.
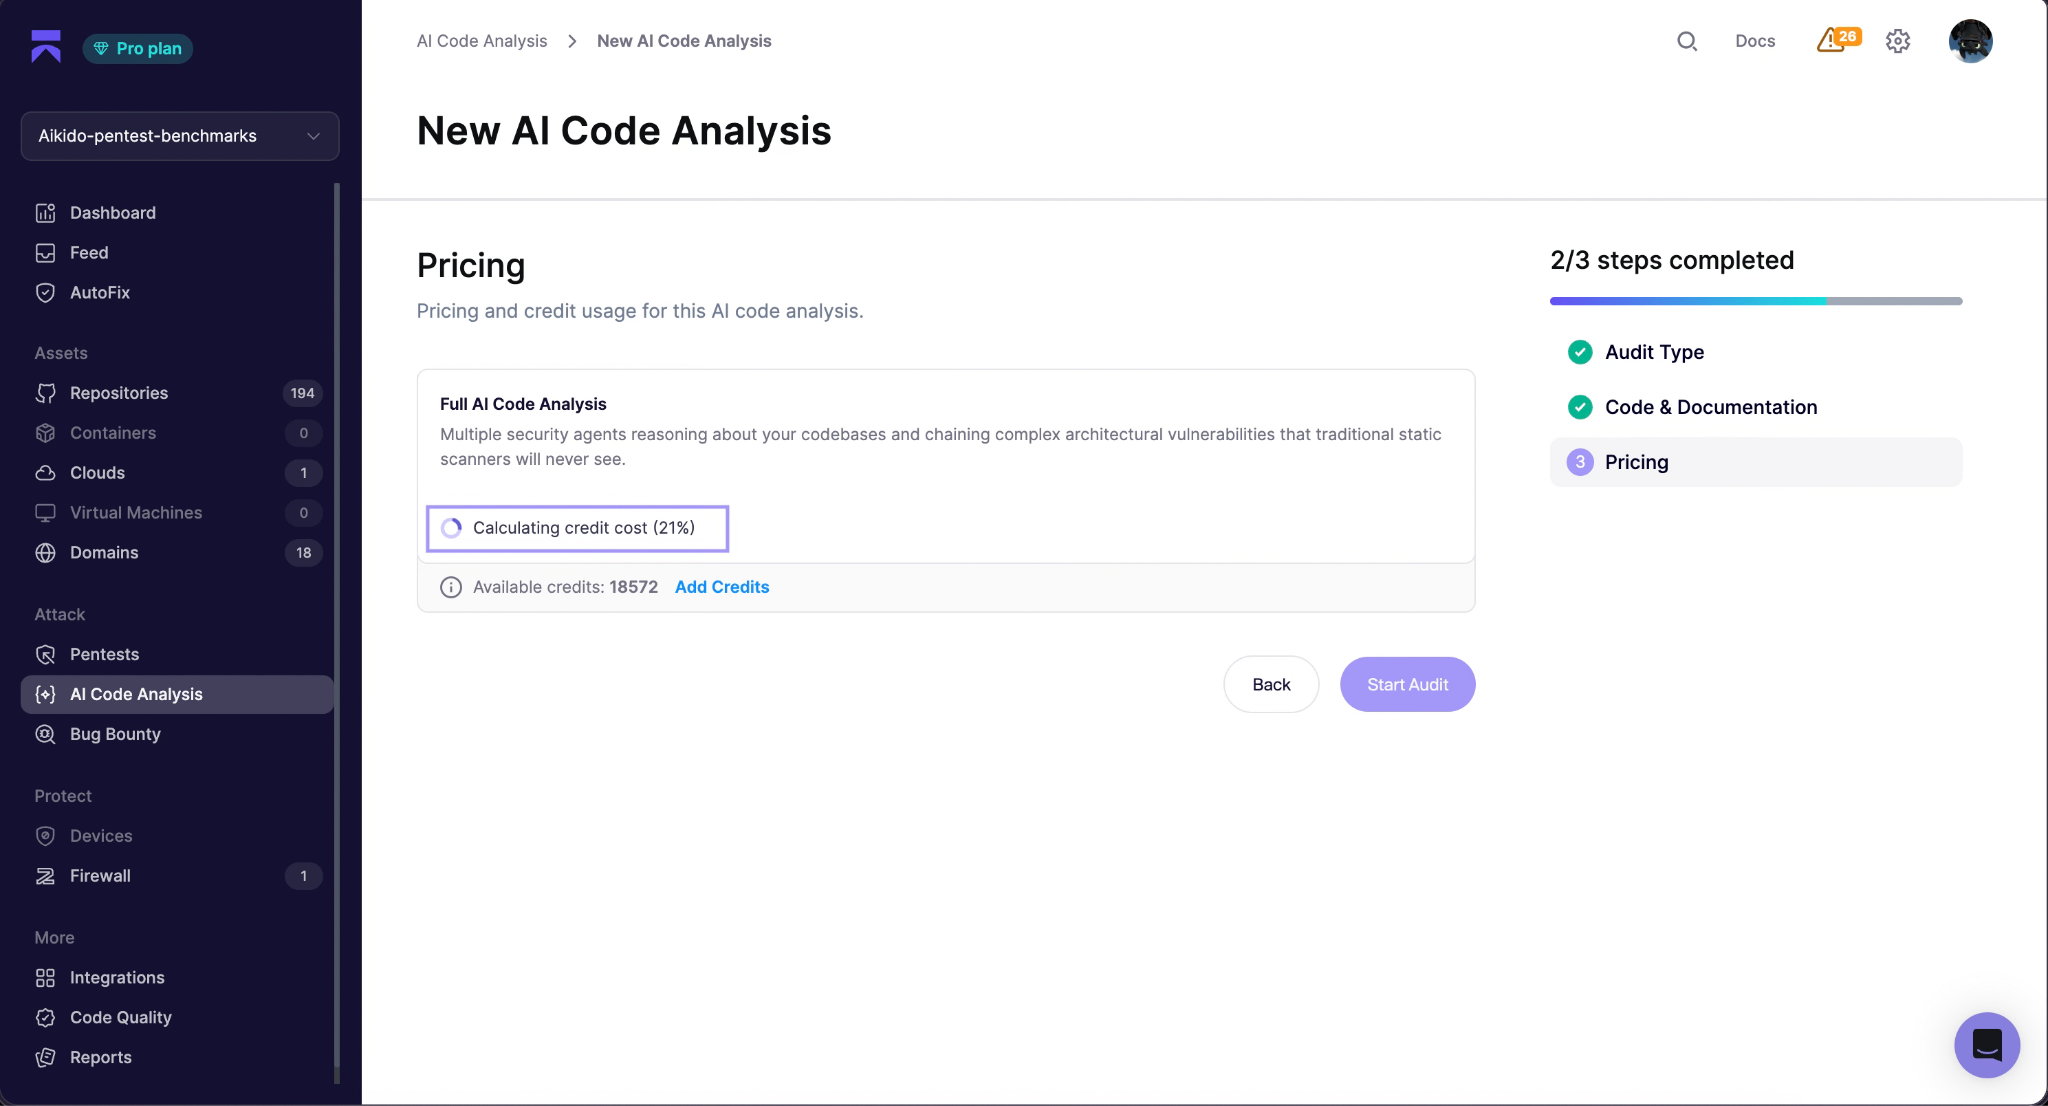
Und wenn Sie der Meinung sind, dass das Repository eine noch intensivere Abdeckung verdient, als von uns automatisch geschätzt, haben Sie die Freiheit, diese zu erhöhen.
Bei unserem Claude Security-Durchlauf wurde im Vorfeld keine Kostenschätzung bereitgestellt, und die Gesamtsumme stand erst nach Abschluss des Scans fest.
Das für den Scan verwendete Repository umfasst rund 15.000 Zeilen Code. Bei einem Repository dieser Größe ist es verkraftbar, keine Option zur Ansicht einer Kostenschätzung im Voraus oder zur Anpassung des Analyseaufwands an das Budget zu haben. Dies wird jedoch zu einem weitaus größeren Problem, wenn die Kosten für die Schwachstellen-Suche mit der Repository-Größe, dem Anwendungstyp und der Pipeline-Komplexität steigen.
Setzen Sie ein teures Modell bei einem Monorepo ein oder führen Sie es bei jedem Pull-Request aus, kann das Fehlen einer Schätzung vor dem Scan dazu führen, dass die Kosten Ihre Erwartungen deutlich übertreffen.
Was das bedeutet
Wir argumentieren schon länger, dass das Design des Harness die Sicherheitsergebnisse stärker bestimmt als das zugrundeliegende Modell. Dieser Benchmark gibt uns einen ersten Einblick in direkte Vergleichszahlen, indem Mythos 5 und Codex Security gegen Code Security Audit an denselben Repositories getestet wurden – und das Harness dennoch den Unterschied ausmachte.
Natürlich schließt ein einzelner Benchmark die Diskussion nicht ab, aber er liefert den Beleg dafür, dass die These „Harness vor Modell“ nicht mehr nur auf Annahmen beruht.


